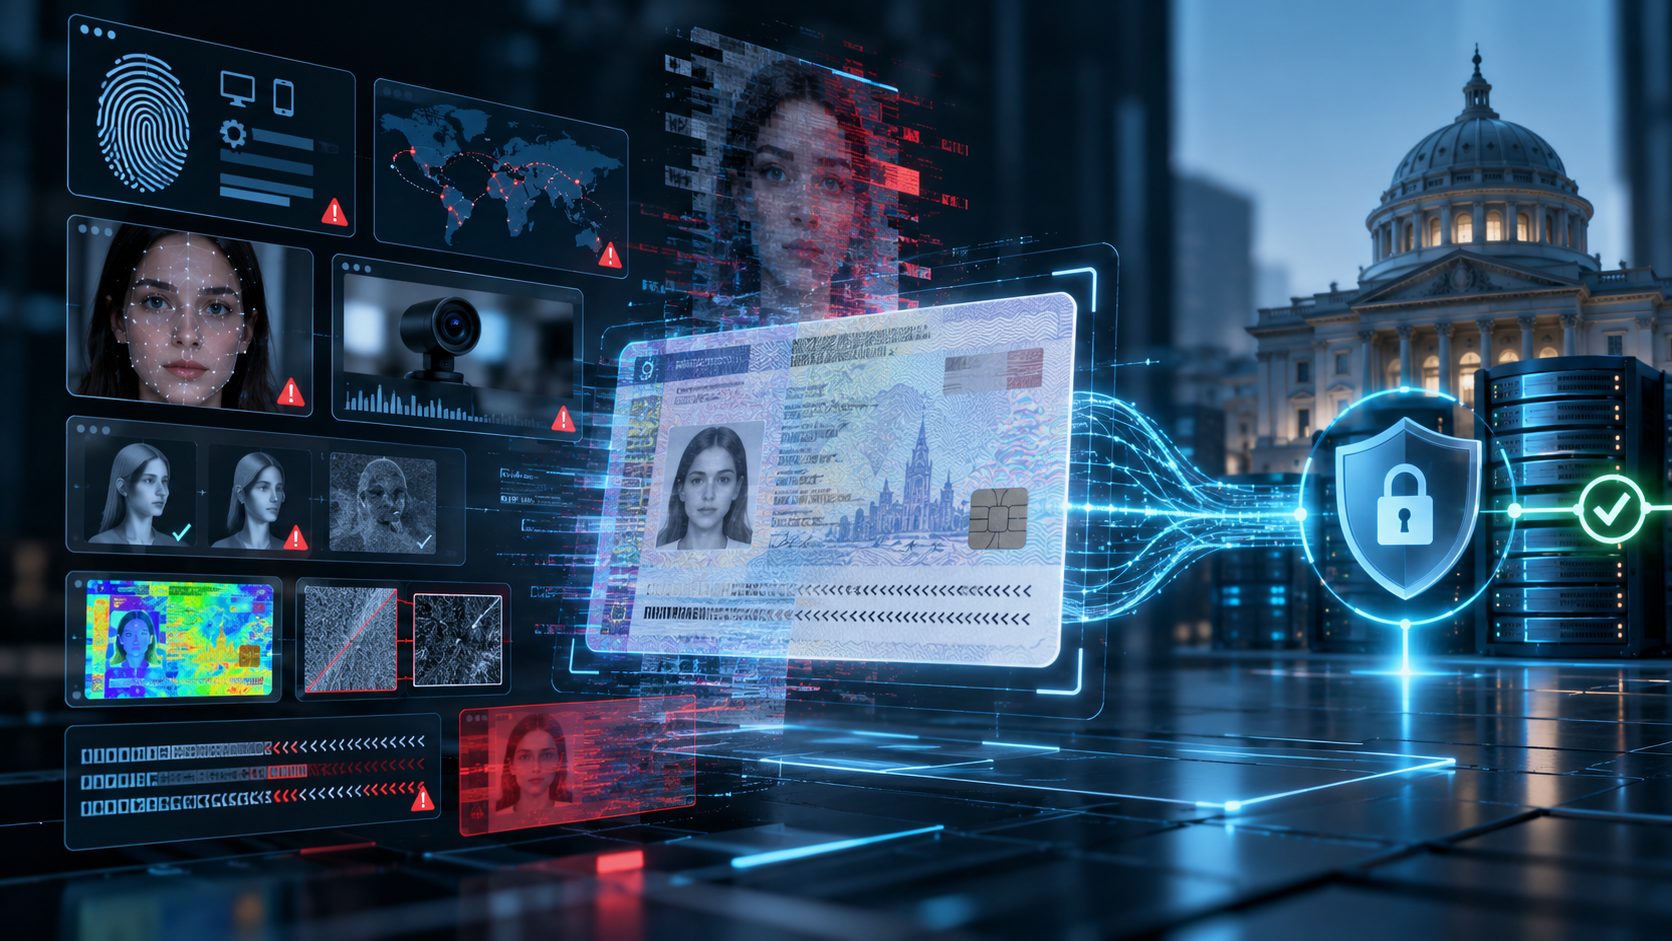
Багато рішень для віддаленої ідентифікації базують свій остаточний висновок на непрямих ознаках: оточенні браузера, мережевому відбитку, телеметрії камери та статистиці зображення. Ці дані корисні для оцінки ризику, але стають слабкою основою захисту, якщо система сприймає їх як незалежне підтвердження автентичності. З розвитком генеративного ШІ та атак із підміною медіапотоку різниця між правдоподібним і підтвердженим документом стала принциповою. Цю загрозу окремо розглядають NIST та ENISA.[1][2]
Що насправді має підтверджувати перевірка
Надійний процес розрізняє три незалежні питання:
- Справжність документа: чи відповідає пред’явлений носій або цифрове свідоцтво документу, виданому уповноваженим джерелом?
- Дійсність відомостей: чи підтверджуються реквізити, факт видачі та, коли це можливо, актуальний статус документа довіреним джерелом?
- Належність пред’явнику: чи є достатні підстави вважати, що перевірку проходить саме особа, якій документ видано?
Збіг полів або відсутність ознак редагування зображення охоплює лише частину першого питання. NIST SP 800-63A-4 чітко розмежовує встановлення особи, перевірку достовірності свідоцтв та підтвердження зв’язку пред’явника із заявленою особою.[1]
Вісім слабких місць поширених підходів
1. Довіра до JavaScript та середовища браузера
Деякі системи роблять висновок про тип пристрою та «природність» сесії на основі User-Agent, navigator.platform, мові, часовому поясі, сенсорному введенню, параметрам екрану, Canvas/WebGL-відбиткам та іншим даним JavaScript.
Проблема — джерело довіри. Браузерне середовище контролюється стороною, яка ініціює запит. Тому її твердження не можна прирівнювати до апаратно підтверджених фактів. Перевірка JavaScript підходить для пошуку невідповідностей та підвищення оцінки ризику, але не повинна самостійно вирішувати, чи є пристрій справжнім і чи допустима ідентифікація. OWASP окремо вимагає повторної перевірки значущих умов на сервері.[3]
2. Статичні списки proxy/VPN та єдиний мережевий відбиток p0f
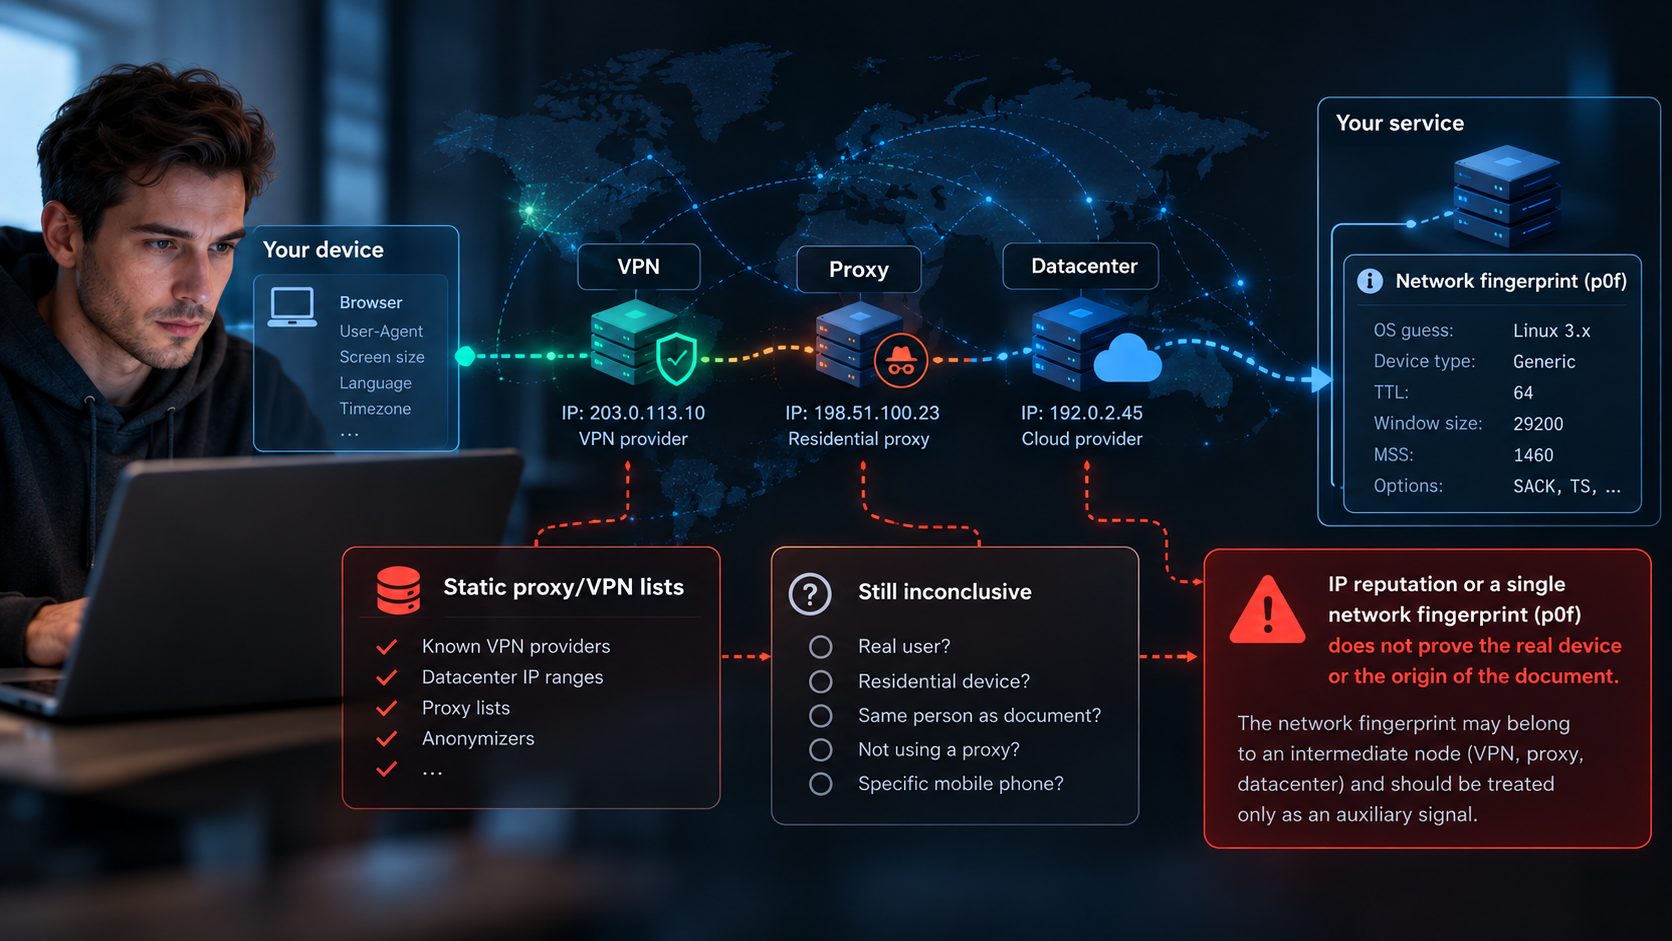
IP-репутація, списки дата-центрів, відомих VPN, проксі та анонімізаторів дають корисні сигнали, але не доводять походження документа. Статичні списки не охоплюють усі можливі маршрути трафіку, а використання або відсутність проксі-сервера саме по собі не визначає добросовісність користувача.
p0f Аналізує пасивні ознаки стеку TCP/IP. Це не механізм атестації фізичного пристрою. Під час роботи через прикладний проксі мережевий відбиток може стосуватися проміжного вузла, а не вихідного клієнта. Розробники p0f також рекомендують трактувати результат як допоміжний сигнал.[4] Перевірка лише за IP або p0f не здатна достовірно встановити, що за запитом стоїть конкретний мобільний телефон.
3. Запис параметрів камери та телеметрії за N кадрів
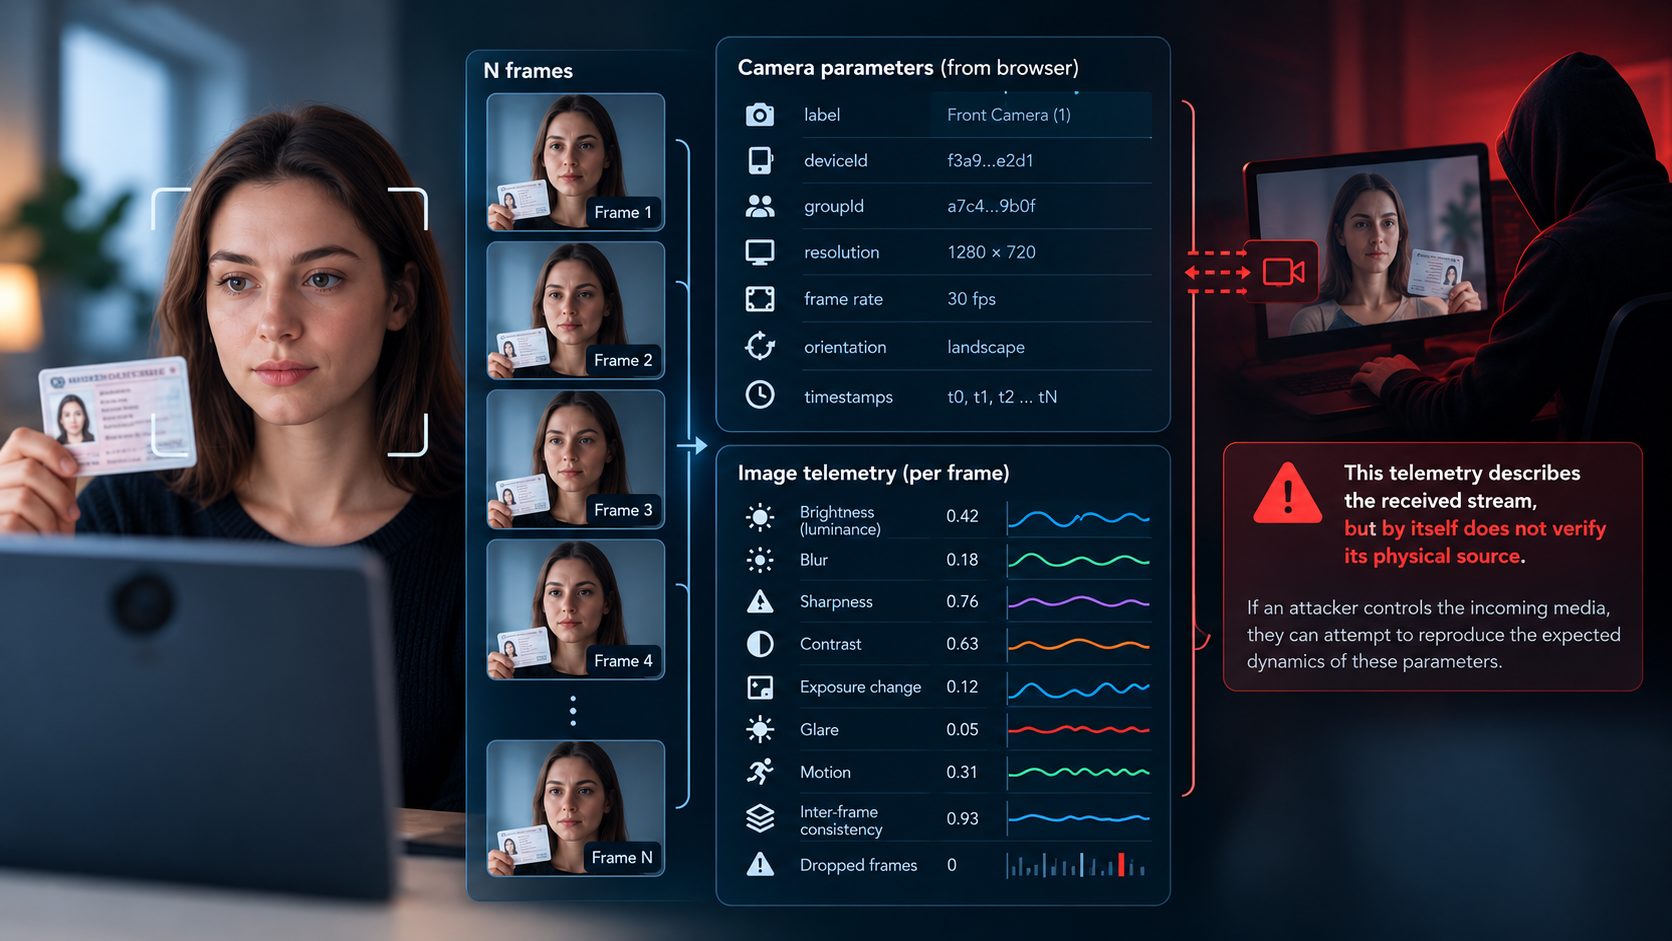
Під час зйомки сервіс може збирати назву камери (label), deviceId, groupId, роздільну здатність, частоту кадрів, орієнтацію камери, часові мітки та послідовність зображень. З самих кадрів додатково обчислюють яскравість (luminance), розмитість (blur), різкість, контраст, зміни експозиції, відблиски, рух, міжкадрову узгодженість та пропуски кадрів. Доступність конкретних параметрів залежить від браузера, пристрою та дозволів.[5][6]
Така телеметрія описує отриманий потік, але сама по собі не підтверджує його фізичне джерело. Якщо зловмисник контролює вхідні медіадані, він може намагатися відтворити очікувану динаміку показників. Захоплення декількох кадрів, аналіз освітлення та запити на рух ускладнюють атаку, однак не замінюють перевірку походження сигналу та захист від цифрової ін’єкції.[2]
4. Статичний аналіз зображення: теплова карта, шум та артефакти
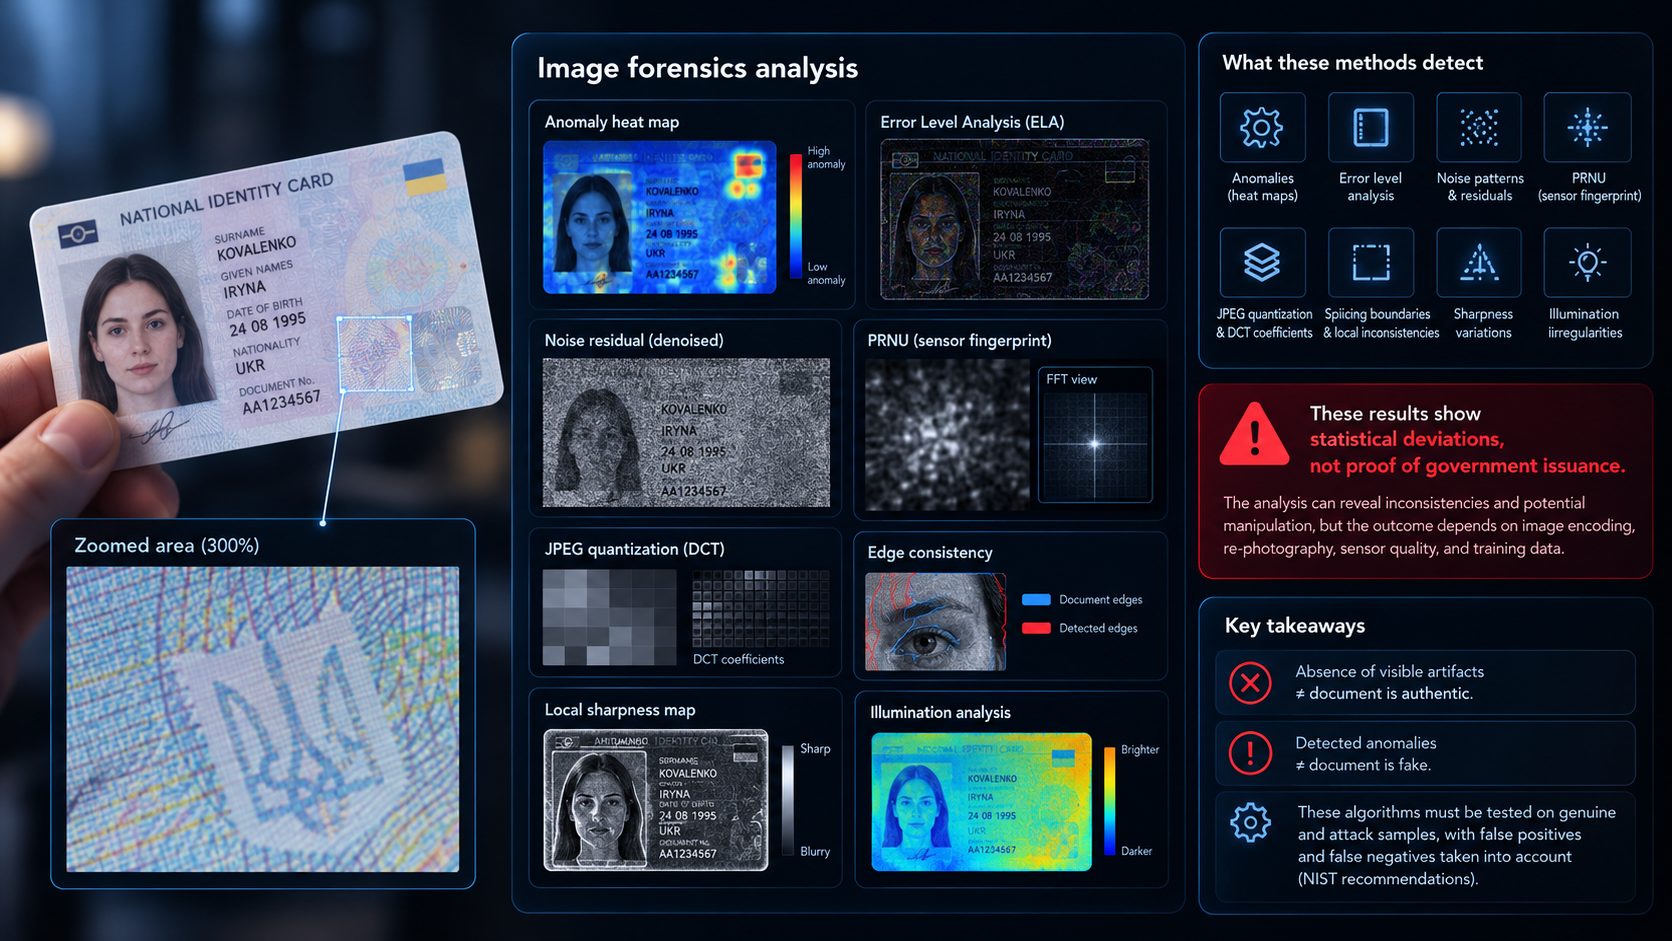
Алгоритми аналізують карти аномалій (heat maps), Error Level Analysis, шумові залишки, ознаки PRNU, JPEG-квантування, DCT-коефіцієнти, межі вставок, локальні зміни різкості, неоднорідність освітлення, геометрію символів та збіг із шаблоном документа.
Ці методи виявляють статистичні відхилення, а не факт державного видавання. Результат залежить від кодування, повторної зйомки, якості сенсора та розподілу навчальних даних. Відсутність помітних артефактів не доводить справжність, а виявлена аномалія не завжди означає підробку. NIST вимагає перевіряти такі алгоритми на справжніх та атакуючих зразках і враховувати помилкові спрацьовування та пропуски.[2]
5. Формальна відповідність MRZ, штрих-коду та друкованих даних
Порівняння візуальної зони (VIZ) з машиночитаною зоною (MRZ), перевірка контрольних цифр, дат і структури двовимірних кодів є необхідними. Але коректна контрольна цифра підтверджує узгодженість даних, а не те, що державний орган коли-небудь випускав документ із цими реквізитами.
Зворотна помилка ще небезпечніша: система помічає розбіжність між MRZ та лицьовою стороною, але не блокує позитивний вердикт. У NIST SP 800-63A-4 порівняння MRZ або штрих-коду з надрукованими даними прямо включено до вимог до автоматизованої оптичної перевірки.[2]
6. «Динамічні» токени без захисту від повторного використання
nonce, ідентифікатор операції та одноразовий challenge корисні лише тоді, коли сервер перевіряє їхній термін дії, прив’язку до сесії та етапу процесу, а також факт попереднього використання. Випадково згенерований рядок не є захистом, якщо його можна багаторазово пред’являти для різних перевірок.
Захист від повторного використання повинен забезпечуватися серверною логікою та, де це доречно, криптографічною прив’язкою результату до конкретної операції. OWASP розглядає повторне використання токенів та пропуск етапів процесу як ризики бізнес-логіки API.[7]
7. Liveness та розпізнавання обличчя як заміна перевірки документа
Перевірка присутності людини (liveness / PAD) та порівняння обличчя з фотографією вирішують важливі, але обмежені завдання. Навіть успішне біометричне зіставлення не підтверджує факт видачі документа або те, що людина, чиє обличчя зображено на документі, є тією, за кого вона себе видає. Крім того, тестування PAD та стійкість усього ланцюжка до цифрової підміни — це різні види оцінки. ISO/IEC 30107-3:2023 присвячений випробуванням PAD, але не передбачає оцінку безпеки всієї системи віддаленої ідентифікації.[8]
8. Самонавчальні моделі без захисту від отруєння даних
Особливий ризик виникає, коли система автоматично використовує результати завантажених користувачем даних або слабо перевірений зворотний зв’язок для зміни ваг моделі. Без надійної розмітки, карантину нових прикладів, контролю версій та незалежної валідації зловмисник отримує можливість впливати на майбутні рішення.
Цей клас загроз відомий як data poisoning і детально розглядається NIST у таксономії атак на системи машинного навчання.[9]
Чому проблема загострилася в епоху генеративного ШІ
Захист, заснований лише на очікуваній послідовності спостережень, вразливий до відтворення: якщо сервер отримує вже сформований потік, він не може автоматично вважати виміряні blur, luminance, рух і затримки незалежними свідченнями реальної зйомки. Детерміновані клієнтські перевірки при достатньому контролі вхідних даних у ряді сценаріїв можна повторити з високою точністю.
Це не означає, що будь-який алгоритм гарантовано обходиться або що всі механізми liveness марні. Захист стає міцнішим за умови непередбачуваних перевірок, підтвердження автентичності сенсора, серверної прив’язки сесії, незалежних джерел даних та криптографічної перевірки. Однак жоден із цих факторів сам по собі не є доказом реальної особистості. ENISA виділяє атаки з цифровою ін’єкцією та підробленими медіа як значущі загрози віддаленій ідентифікації.[10]
Що ми виявляли під час перевірок з дозволу замовників
У рамках досліджень, узгоджених із власниками систем, наша команда зафіксувала такі класи помилок:
- Довіра до User-Agent. Частина реалізацій приймала заяву про мобільний браузер без достатньої незалежної перевірки характеристик з’єднання та пристрою.
- Повторне використання захисних параметрів. Параметри, заявлені як «динамічні», приймалися сервером повторно без належного контролю життєвого циклу.
- Отруєння live-learning. В одній самописній системі завантажувані підроблені документи впливали на навчальний контур, і ознаки таких зразків почали отримувати перевагу перед раніше зафіксованими еталонними критеріями.
- Ігнорування суперечностей. В одній із реалізацій невідповідність між даними машиночитаної зони та візуальною частиною документа не перешкоджала позитивному рішенню.
Про виявлені недоліки було повідомлено відповідальні сторони та виробників. Наведені випадки — результати наших приватних аудитів, а не публічний статистичний зріз ринку: назви систем, обсяг вибірки та відтворювані матеріали тут не розкриваються. Вони ілюструють конкретні помилки проектування й не означають, що всі постачальники допускають такі самі вразливості.
Головна межа довіри — джерело видачі, а не зображення
Документ може виглядати ідеально та бути внутрішньо узгодженим, але містити реквізити неіснуючої або непідтвердженої уповноваженим джерелом особи. Тому вердикт «ознак монтажу не виявлено» не можна підміняти вердиктом «особа встановлена».
За наявності законного та технічного доступу перевірка має зіставляти ключові атрибути та статус документа з державним реєстром, джерелом видачі або іншим авторитетним чи перевіреним джерелом. Для електронних паспортів існує окремий криптографічний шлях: перевірка цифрового підпису даних чіпа та ланцюга довіри DSC → CSCA, описаний ICAO. Вона підтверджує походження та цілісність підписаних даних, але сама по собі не замінює перевірку актуального статусу документа та зв’язку з пред’явником.[1][11]
Якщо доступ до надійного джерела відсутній, правильний результат — «справжність видачі або актуальний статус не підтверджені», а не безумовне «документ справжній». Відсутність відповіді реєстру при цьому не доводить підробку: система повинна розрізняти негативний результат перевірки та відсутність можливості перевірити.
| Рівень | Що він показує | Чого він не доводить |
|---|---|---|
| Середовище браузера та мережа | Наявність ознак ризику у з'єднанні та сесії | Справжність пристрою, документа або особи |
| Камера, liveness та медіааналіз | Узгодженість спостережуваного потоку та ознаки підміни | Факт державного видавання документа |
| OCR, MRZ, коди та шаблони | Формат та внутрішня узгодженість реквізитів | Наявність запису в емітента |
| Цифровий підпис та ланцюжок довіри | Походження та цілісність підписаних даних при коректній валідації | Поточний статус та законність використання пред’явником |
| Авторитетне джерело та перевірка пред’явника | Підтвердження доступних атрибутів, статусу та зв’язку з особою | Абсолютна відсутність шахрайства в будь-якому подальшому сценарії |
Наш підхід: перевірка реальних підстав для довіри, а не лише непрямих ознак
Ми оцінюємо систему не за кількістю датчиків, сигнатур та алгоритмів у презентації, а за тим, яке саме твердження здатна довести кожна перевірка та як вона поводиться під час цілеспрямованої атаки. Для замовника будуємо модель захисту з урахуванням документів, юрисдикції, сценарію використання та допустимого рівня ризику.
- Незалежні рівні контролю. Браузерні, мережеві та візуальні ознаки враховуються як додаткові сигнали ризику, а не як самостійний доказ.
- Захищений процес перевірки. Серверний контроль етапів, одноразовість та прив’язка challenge, виявлення повторів та захист від цифрової підміни потоку.
- Верифікація походження документа. Перевірка допустимих криптографічних свідчень та інтеграція з офіційними або іншими авторитетними джерелами там, де це юридично та технічно можливо.
- Захист навчального контуру. Роздільне зберігання завантажених користувачем даних та еталонної розмітки, контрольоване оновлення моделей, перевірка відхилень якості та можливість відкоту.
- Вимірювана стійкість. Оцінка помилкових припущень та відхилень (включно з
DFAR/DFRRдля аналізу документів), випробування на підміну потоку, повтори, суперечливі поля та нові типи синтетичних зображень.
Для нас ретельна перевірка — це не обіцянка «100% захисту», а відтворювана процедура зі зрозумілими джерелами довіри, перевіреними метриками та чітким розмежуванням станів «підтверджено», «не підтверджено» та «виявлено суперечність».
Потрібен захист від підроблених документів під ваші потреби?
Універсального фільтра, однаково надійного для всіх документів і каналів перевірки, не існує. Якщо ваша мета — зменшити зловживання фальшивими документами, перевірити стійкість чинного KYC-процесу або розробити індивідуальне рішення під конкретну юрисдикцію та модель загроз, звертайтеся до нас.
Ми допоможемо виявити, де система покладається на імітовані сигнали, визначити необхідні джерела довіри та спроектувати перевірку, стійкість якої можна підтвердити технічним випробуванням, а не маркетинговою обіцянкою.
Технічні джерела
Джерела підтверджують загальні технічні властивості, моделі загроз та стандарти. Конкретні результати наших аудитів описані вище окремо.
- NIST SP 800-63A-4 — Identity Proofing Overview. Розмежування встановлення особи, перевірки посвідчень та верифікації пред’явника; авторитетні та достовірні джерела.
- NIST SP 800-63A-4 — Identity Proofing Requirements. Оптичний аналіз, MRZ, підміна медіапотоку, атаки з використанням генеративного ШІ та вимоги до тестування.
- OWASP — Input Validation Cheat Sheet. Недовіра до клієнтської перевірки та обов’язкова валідація сервером.
- p0f — документація проєкту. Призначення пасивного TCP/IP-фінгерпринтингу та обмеження методу.
- MDN — MediaDevices.enumerateDevices(). Перелік медіапристроїв та обмеження доступу до їхніх метаданих.
- MDN — MediaStreamTrack.getSettings(). Доступні параметри медіапотоку.
- OWASP — REST Security Cheat Sheet. Захист стану API, послідовності кроків та токенів від повторного використання.
- ISO/IEC 30107-3:2023. Методи випробувань та звітності для біометричного виявлення атак пред'явлення (PAD).
- NIST AI 100-2e2025 — Adversarial Machine Learning. Класифікація атак, включаючи отруєння даних і моделей.
- ENISA — Remote ID Proofing: Good Practices (2024). Загрози віддаленої ідентифікації, включаючи атаки пред’явлення та цифрову ін’єкцію.
- ICAO — ePassport Basics. Цифрові підписи електронних паспортів та ланцюг довіри DSC/CSCA.