De nombreuses solutions d’identification à distance fondent leur verdict final sur des indices indirects : l’environnement du navigateur, l’empreinte réseau, les données télémétriques de la caméra et les statistiques d’image. Ces données sont utiles pour évaluer les risques, mais constituent une base de protection insuffisante si le système les considère comme une confirmation indépendante de l’authenticité. Avec le développement de l’IA générative et des attaques par substitution de flux multimédia, la distinction entre un document plausible et un document vérifié est devenue fondamentale. Cette menace fait l’objet d’une analyse distincte de la part du NIST et de l’ENISA.[1][2]
Ce que la vérification doit réellement confirmer
Un processus fiable distingue trois questions indépendantes :
- L’authenticité du document : le support ou le certificat numérique présenté correspond-il à un document émis par une source autorisée ?
- La validité des informations : les données d’identification, le fait de la délivrance et, lorsque cela est possible, le statut actuel du document sont-ils confirmés par une source fiable ?
- Identité du présentateur : existe-t-il des motifs suffisants pour considérer que c’est bien la personne à laquelle le document a été délivré qui se soumet à la vérification ?
La correspondance des champs ou l’absence de traces de modification de l’image ne répond qu’en partie à la première question. La norme NIST SP 800-63A-4 distingue clairement l’identification, la vérification de l’authenticité des certificats et la confirmation du lien entre le présentateur et l’identité déclarée.[1]
Huit faiblesses des approches courantes
1. Confiance accordée à JavaScript et à l’environnement du navigateur
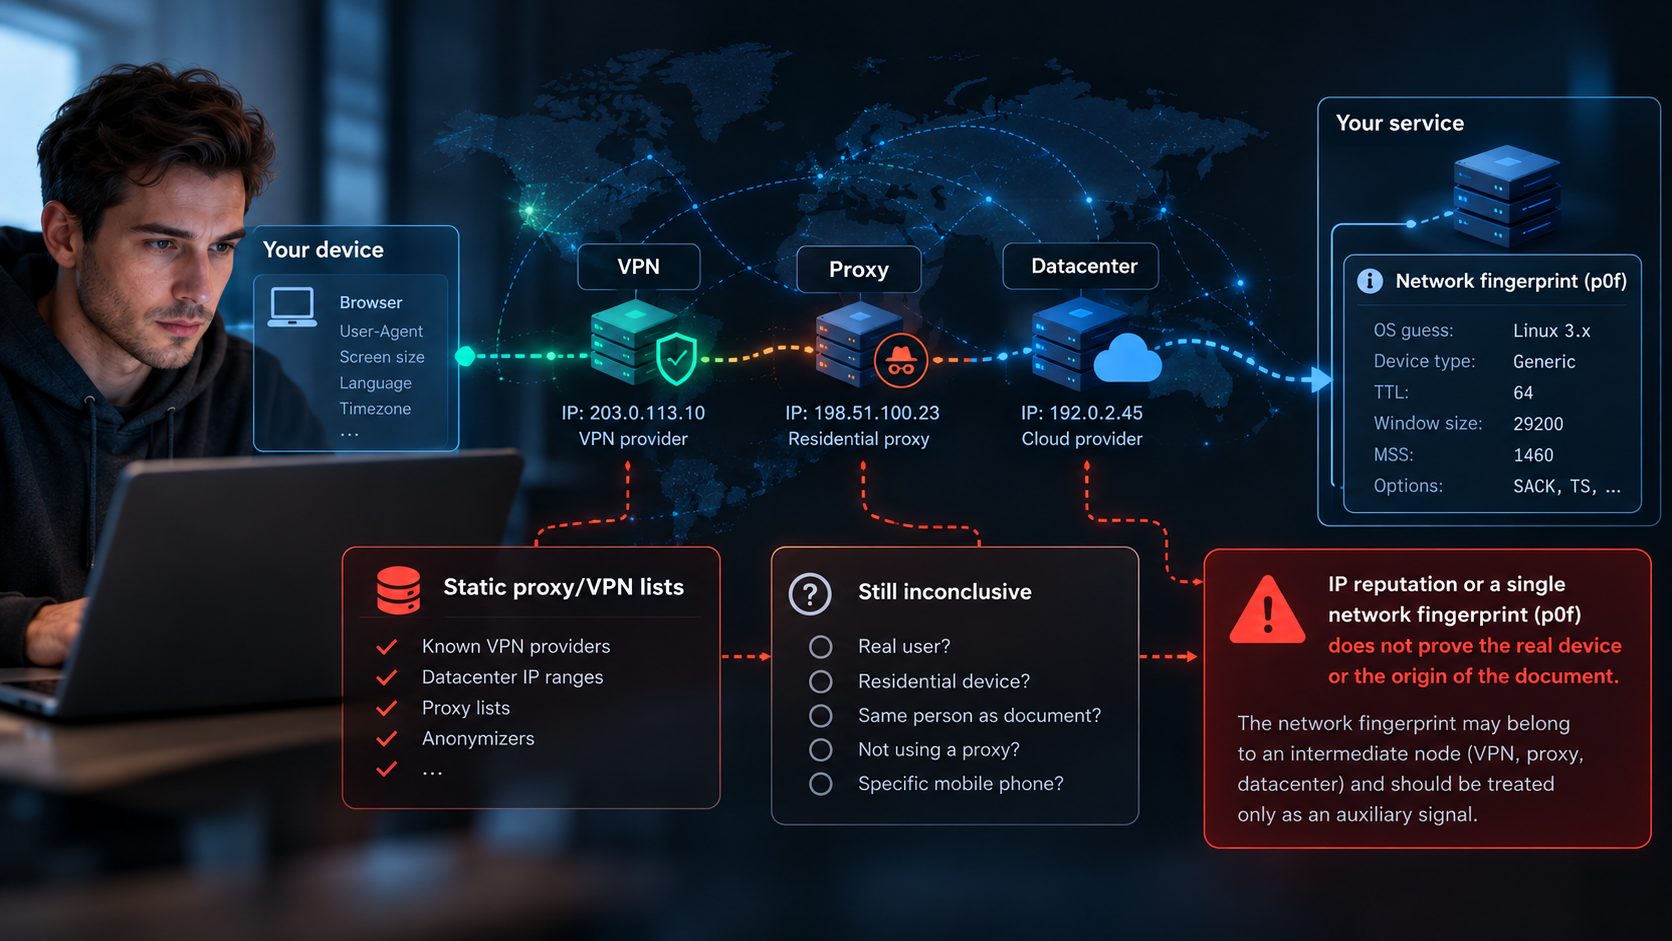
Certains systèmes déduisent le type d’appareil et le caractère « naturel » d’une session à partir User-Agent, navigator.platform, la langue, le fuseau horaire, les entrées tactiles, les paramètres d’écran, les empreintes Canvas/WebGL et d’autres données JavaScript.
Le problème réside dans la source de cette confiance. L’environnement du navigateur est contrôlé par la partie à l’origine de la requête. Par conséquent, ses déclarations ne peuvent être assimilées à des faits confirmés au niveau matériel. La vérification JavaScript est utile pour détecter les incohérences et affiner l’évaluation des risques, mais elle ne doit pas déterminer à elle seule si l’appareil est authentique et si l’identification est valable. L’OWASP exige par ailleurs une vérification supplémentaire des conditions pertinentes sur le serveur.[3]
2. Listes statiques de proxys/VPN et empreinte réseau unique p0f
La réputation IP, les listes de centres de données, de VPN connus, de proxys et d’anonymiseurs fournissent des indications utiles, mais ne prouvent pas l’origine du document. Les listes statiques ne couvrent pas tous les itinéraires de trafic possibles, et l’utilisation ou l’absence de proxy ne détermine pas en soi la bonne foi de l’utilisateur.
p0f p0f analyse les caractéristiques passives de la pile TCP/IP. Il ne s’agit pas d’un mécanisme d’authentification d’un périphérique physique. En cas d’utilisation d’un proxy applicatif, l’empreinte réseau peut correspondre à un nœud intermédiaire et non au client d’origine. Les développeurs de p0f recommandent également de considérer ce résultat comme un indicateur auxiliaire.[4] Une vérification basée uniquement sur l’adresse IP ou sur p0f ne permet pas d’établir de manière fiable qu’une requête provient d’un téléphone mobile spécifique.
3. Enregistrement des paramètres de l'appareil photo et des données de télémétrie sur N images
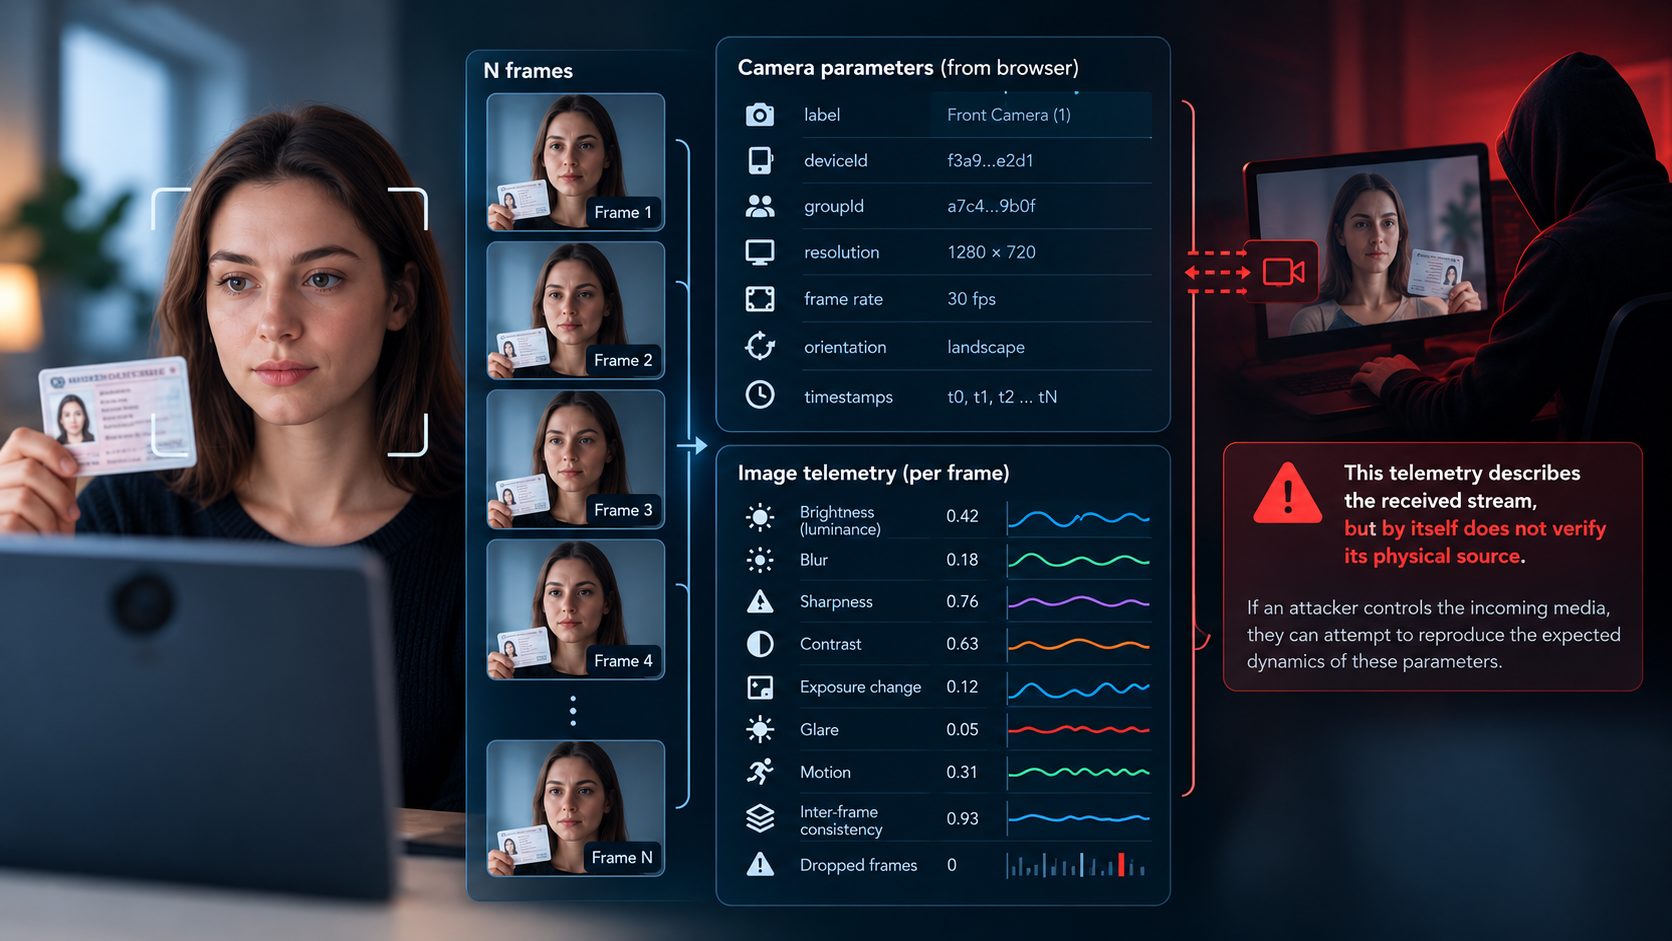
Pendant la prise de vue, le service peut collecter le nom de l’appareil photo (label), deviceId, groupId, la résolution, la fréquence d’images, l’orientation de la caméra, les horodatages et la séquence d’images. À partir des images elles-mêmes, on calcule en outre la luminosité (luminance), le flou (blur), la netteté, le contraste, les variations d’exposition, les reflets, le mouvement, la cohérence inter-images et les images manquantes. La disponibilité de certains paramètres dépend du navigateur, de l’appareil et des autorisations.[5][6]
Cette télémétrie décrit le flux reçu, mais ne certifie pas en soi sa source physique. Si un attaquant contrôle le flux multimédia entrant, il peut tenter de reproduire l'évolution attendue des indicateurs. La capture de plusieurs images, l’analyse de l’éclairage et les requêtes de mouvement compliquent l’attaque, mais ne remplacent pas la vérification de l’origine du signal ni la protection contre l’injection numérique.[2]
4. Analyse statique de l’image : carte thermique, bruit et artefacts
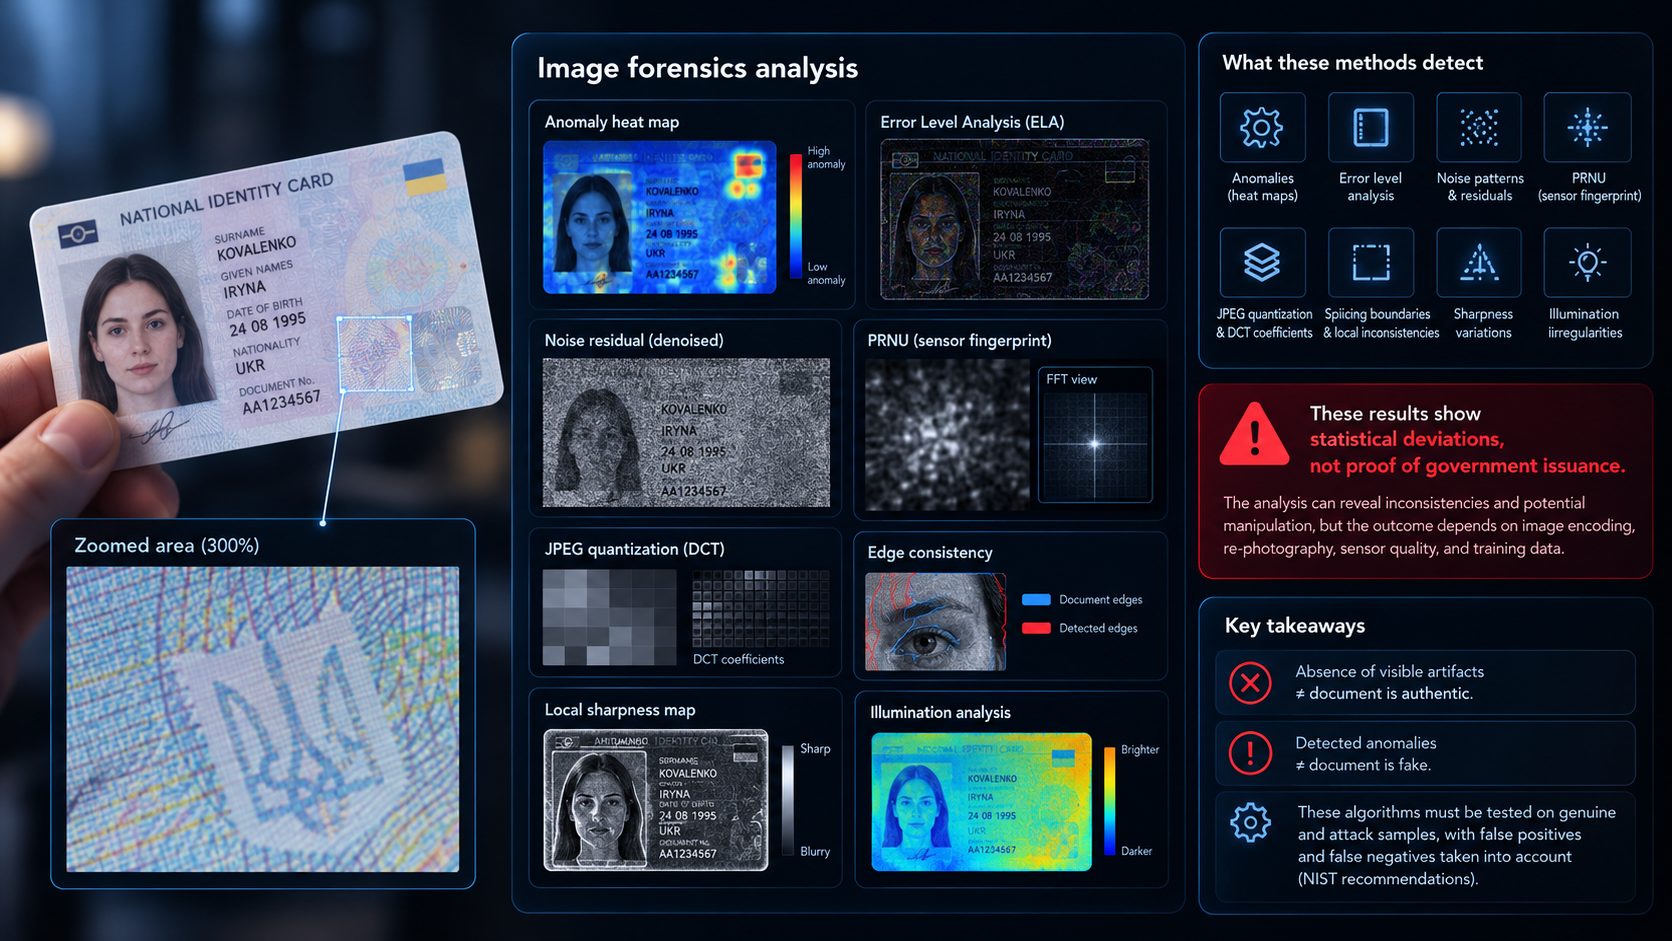
Les algorithmes analysent les cartes d’anomalies (heat maps), l’analyse du niveau d’erreur (Error Level Analysis), les résidus de bruit, les signes de PRNU, la quantification JPEG, les coefficients DCT, les limites d’insertion, les changements locaux de netteté, l’hétérogénéité de l’éclairage, la géométrie des caractères et la correspondance avec le modèle du document.
Ces méthodes détectent des écarts statistiques, et non le fait qu’un document ait été délivré par les autorités. Le résultat dépend du codage, d’une éventuelle nouvelle prise de vue, de la qualité du capteur et de la répartition des données d’apprentissage. L'absence d'artefacts visibles ne prouve pas l'authenticité, et une anomalie détectée ne signifie pas toujours qu'il s'agit d'une contrefaçon. Le NIST exige de tester ces algorithmes sur des échantillons authentiques et des échantillons de test, et de tenir compte des faux positifs et des faux négatifs.[2]
5. Conformité formelle de la MRZ, du code-barres et des données imprimées
Comparaison de la zone visuelle (VIZ) avec la zone lisible par machine (MRZ), la vérification des chiffres de contrôle, des dates et de la structure des codes bidimensionnels sont indispensables. Cependant, un chiffre de contrôle correct confirme la cohérence des données, et non le fait qu’un organisme public ait jamais émis un document comportant ces éléments.
L'erreur inverse est encore plus dangereuse : le système détecte une divergence entre la MRZ et le recto, mais ne bloque pas le verdict positif. Dans la norme NIST SP 800-63A-4, la comparaison de la MRZ ou du code-barres avec les données imprimées est explicitement incluse dans les exigences relatives à la vérification optique automatisée.[2]
6. Les jetons « dynamiques » sans protection contre la réutilisation
nonce, l’identifiant d’opération et le challenge à usage unique ne sont utiles que si le serveur vérifie leur durée de validité, leur lien avec la session et l’étape du processus, ainsi que le fait qu’ils aient déjà été utilisés. Une chaîne générée aléatoirement ne constitue pas une protection si elle peut être présentée à plusieurs reprises pour différentes vérifications.
La protection contre la réutilisation doit être assurée par la logique côté serveur et, le cas échéant, par un lien cryptographique entre le résultat et une opération spécifique. L’OWASP considère la réutilisation des jetons et le contournement d’étapes du processus comme des risques liés à la logique métier des API.[7]
7. Vérification de la présence en temps réel et reconnaissance faciale en remplacement de la vérification des documents
La vérification de la présence d’une personne (liveness / PAD) et la comparaison du visage avec une photo répondent à des besoins importants, mais limités. Même une correspondance biométrique réussie ne prouve pas que le document a bien été délivré, ni que la personne dont le visage figure sur le document est bien celle qu’elle prétend être. De plus, les tests PAD et la résistance de l’ensemble de la chaîne à la substitution numérique constituent des types d’évaluation distincts. La norme ISO/IEC 30107-3:2023 est consacrée aux essais PAD, mais ne prétend pas évaluer la sécurité de l’ensemble du système d’identification à distance.[8]
8. Modèles auto-apprenants sans protection contre l’empoisonnement des données
Un risque particulier survient lorsque le système utilise automatiquement les résultats des données fournies par les utilisateurs ou des retours d’expérience peu vérifiés pour modifier les poids du modèle. En l’absence de marquage de confiance, de mise en quarantaine des nouveaux exemples, de contrôle des versions et de validation indépendante, un attaquant a la possibilité d’influencer les décisions futures.
Cette catégorie de menaces est connue sous le nom de data poisoning et est examinée en détail par le NIST dans sa taxonomie des attaques contre les systèmes d’apprentissage automatique.[9]
Pourquoi le problème s’est-il aggravé à l’ère de l’IA générative ?
Une protection reposant uniquement sur une séquence attendue d’observations est vulnérable à la reproduction : si le serveur reçoit un flux déjà généré, il ne peut pas considérer automatiquement les mesures blur, luminance, le mouvement et les délais comme des preuves indépendantes d’un enregistrement réel. Les vérifications déterministes côté client, avec un contrôle suffisant des données d’entrée, peuvent être reproduites avec une grande précision dans un certain nombre de scénarios.
Cela ne signifie pas pour autant que n’importe quel algorithme puisse être contourné à coup sûr, ni que tous les mécanismes de vérification de l’activité soient inutiles. La protection est renforcée par des vérifications imprévisibles, la validation de l’authenticité du capteur, l’association de la session au serveur, des sources de données indépendantes et une vérification cryptographique. Cependant, aucun de ces facteurs pris isolément ne constitue une preuve de l’identité réelle. L’ENISA identifie les attaques par injection numérique et les supports falsifiés comme des menaces significatives pour l’identification à distance.[10]
Ce que nous avons constaté lors des audits réalisés avec l’autorisation des clients
Dans le cadre d’études menées en accord avec les propriétaires des systèmes, notre équipe a relevé les catégories d’erreurs suivantes :
- Confiance dans l’User-Agent. Certaines implémentations acceptaient la déclaration d’un navigateur mobile sans vérification indépendante suffisante des caractéristiques de la connexion et de l’appareil.
- Réutilisation des paramètres de sécurité. Des paramètres présentés comme « dynamiques » étaient réutilisés par le serveur sans contrôle adéquat de leur cycle de vie.
- Contamination de l’apprentissage en temps réel. Dans un système développé en interne, des documents falsifiés téléchargés ont influencé la boucle d’apprentissage, et les caractéristiques de ces échantillons ont commencé à prendre le pas sur les critères de référence précédemment établis.
- Ignorance des contradictions. Dans l’une des implémentations, l’incohérence entre les données de la zone lisible par machine et la partie visuelle du document n’empêchait pas une décision positive.
Les parties responsables et les fabricants ont été informés des lacunes identifiées. Les cas cités sont le résultat de nos audits privés et ne constituent pas un échantillon statistique public du marché : les noms des systèmes, la taille de l’échantillon et les documents reproduits ne sont pas divulgués ici. Ils illustrent des erreurs de conception spécifiques et ne signifient pas que tous les fournisseurs présentent les mêmes vulnérabilités.
La principale limite de confiance réside dans la source d’émission, et non dans l’image
Un document peut paraître parfait et présenter une cohérence interne, mais contenir les coordonnées d’une personne inexistante ou non confirmée par une source habilitée. C’est pourquoi le verdict « aucun signe de falsification n’a été détecté » ne saurait se substituer au verdict « identité établie ».
En présence d’un accès légal et technique, la vérification doit comparer les attributs clés et le statut du document avec le registre national, la source d’émission ou toute autre source faisant autorité ou dont l’authenticité peut être vérifiée. Pour les passeports électroniques, il existe une procédure cryptographique distincte : la vérification de la signature numérique des données de la puce et de la chaîne de confiance DSC → CSCA, telle que décrite par l’OACI. Elle confirme l’origine et l’intégrité des données signées, mais ne remplace pas en soi la vérification du statut actuel du document et du lien avec le présentateur.[1][11]
En l’absence d’accès à une source fiable, le résultat correct est « l’authenticité de la délivrance ou le statut actuel ne sont pas confirmés », et non un « le document est authentique » sans réserve. L’absence de réponse du registre ne prouve pas pour autant qu’il s’agisse d’un faux : le système doit faire la distinction entre une vérification négative et l’impossibilité de vérifier.
| Niveau | Ce qu’il indique | Ce qu’il ne prouve pas |
|---|---|---|
| Environnement du navigateur et réseau | Présence de signes de risque au niveau de la connexion et de la session | Authenticité de l'appareil, du document ou de l'identité |
| Caméra, détection de présence et analyse multimédia | Cohérence du flux observé et indices de falsification | Fait que le document ait été délivré par les autorités publiques |
| OCR, MRZ, codes et modèles | Format et cohérence interne des données | Existence d’un enregistrement chez l’émetteur |
| Signature numérique et chaîne de confiance | Origine et intégrité des données signées en cas de validation correcte | Statut actuel et légalité de l’utilisation par le présentateur |
| Source faisant autorité et vérification du porteur | Confirmation des attributs disponibles, du statut et du lien avec l’identité | Absence totale de fraude dans tout scénario ultérieur |
Notre approche : vérifier les fondements réels de la confiance, et pas seulement des indices indirects
Nous évaluons le système non pas en fonction du nombre de capteurs, de signatures et d’algorithmes présentés, mais en fonction de ce que chaque vérification est capable de prouver concrètement et de la manière dont elle se comporte face à une attaque ciblée. Pour le client, nous élaborons un modèle de protection adapté à la documentation, à la juridiction, au scénario d’utilisation et au niveau de risque acceptable.
- Niveaux de contrôle indépendants. Les indicateurs liés au navigateur, au réseau et visuels sont pris en compte comme des signaux de risque supplémentaires, et non comme des preuves à part entière.
- Processus de vérification sécurisé. Contrôle des étapes côté serveur, caractère unique et liaison au « challenge », détection des répétitions et protection contre la falsification numérique du flux.
- Vérification de l’origine du document. Vérification des preuves cryptographiques admissibles et intégration avec des sources officielles ou d’autres sources faisant autorité, lorsque cela est légalement et techniquement possible.
- Protection de la boucle d’apprentissage. Stockage séparé des données fournies par les utilisateurs et des étiquettes de référence, mise à jour contrôlée des modèles, vérification des écarts de qualité et possibilité de retour en arrière.
- Stabilité mesurable. Évaluation des fausses acceptations et des rejets (y compris
DFAR/DFRRl’analyse de documents), tests de substitution de flux, de répétitions, de champs contradictoires et de nouveaux types d’images synthétiques.
Pour nous, une vérification rigoureuse ne consiste pas en une promesse de « protection à 100 % », mais en une procédure reproductible avec des sources de confiance claires, des indicateurs vérifiables et une distinction explicite entre les états « confirmé », « non confirmé » et « contradiction détectée ».
Vous avez besoin d’une protection contre les faux documents adaptée à votre cas de figure ?
Il n’existe pas de filtre universel, aussi fiable pour tous les documents que pour tous les canaux de vérification. Si votre objectif est de réduire les abus liés aux faux documents, de vérifier la robustesse de votre processus KYC actuel ou de mettre en place une solution sur mesure adaptée à une juridiction et à un modèle de menaces spécifiques, n’hésitez pas à nous contacter.
Nous vous aiderons à identifier les points où le système s’appuie sur des signaux imités, à déterminer les sources de confiance nécessaires et à concevoir une vérification dont la robustesse peut être confirmée par des tests techniques, et non par des promesses marketing.
Sources techniques
Ces sources confirment les propriétés techniques générales, les modèles de menaces et les normes. Les résultats spécifiques de nos audits sont décrits séparément ci-dessus.
- NIST SP 800-63A-4 — Identity Proofing Overview. Distinction entre l’établissement de l’identité, la validation des justificatifs et la vérification du porteur ; sources faisant autorité et fiables.
- NIST SP 800-63A-4 — Exigences en matière de vérification d’identité. Analyse optique, MRZ, substitution du flux multimédia, attaques utilisant l’IA générative et exigences en matière de tests.
- OWASP — Fiche pratique sur la validation des entrées. Méfiance à l'égard de la validation côté client et validation obligatoire par le serveur.
- p0f — documentation du projet. Objectif de l’empreinte TCP/IP passive et limites de la méthode.
- MDN — MediaDevices.enumerateDevices(). Liste des périphériques multimédias et restrictions d’accès à leurs métadonnées.
- MDN — MediaStreamTrack.getSettings(). Paramètres disponibles pour le flux multimédia.
- OWASP — REST Security Cheat Sheet. Protection de l’état de l’API, de l’ordre des étapes et des jetons contre la réutilisation.
- ISO/IEC 30107-3:2023. Méthodes d’essai et de rapport pour la détection biométrique des attaques par présentation (PAD).
- NIST AI 100-2e2025 — Apprentissage automatique adversaire. Classification des attaques, y compris l’empoisonnement des données et des modèles.
- ENISA — Vérification d’identité à distance : bonnes pratiques (2024). Menaces liées à l’identification à distance, y compris les attaques par présentation et l’injection numérique.
- OACI — Notions de base sur le passeport électronique. Signatures numériques des passeports électroniques et chaîne de confiance DSC/CSCA.