Muchas soluciones de identificación remota basan su veredicto final en indicios indirectos: el entorno del navegador, la huella de red, la telemetría de la cámara y las estadísticas de la imagen. Estos datos son útiles para evaluar el riesgo, pero se convierten en una base de protección débil si el sistema los toma como una confirmación independiente de la autenticidad. Con el desarrollo de la IA generativa y los ataques de suplantación de flujos multimedia, la distinción entre un documento verosímil y uno verificado se ha convertido en una cuestión fundamental. El NIST y la ENISA abordan esta amenaza por separado.[1][2]
¿Qué debe confirmar realmente la verificación?
Un proceso fiable distingue tres cuestiones independientes:
- Autenticidad del documento: ¿se corresponde el soporte presentado o el certificado digital con el documento emitido por una fuente autorizada?
- Validez de la información: ¿confirma una fuente fiable los datos, el hecho de la emisión y, cuando sea posible, el estado actual del documento?
- Identidad del presentador: ¿existen motivos suficientes para considerar que quien se somete a la verificación es precisamente la persona a la que se expidió el documento?
La coincidencia de los campos o la ausencia de indicios de edición de la imagen solo resuelve una parte de la primera cuestión. La norma NIST SP 800-63A-4 distingue claramente entre la identificación de la persona, la verificación de la autenticidad de los certificados y la confirmación de la relación del presentador con la identidad declarada.[1]
Ocho puntos débiles de los enfoques habituales
1. Confianza en JavaScript y en el entorno del navegador
Algunos sistemas deducen el tipo de dispositivo y la «naturalidad» de la sesión a partir de User-Agent, navigator.platformel lenguaje, la zona horaria, la entrada táctil, los parámetros de pantalla, las huellas de Canvas/WebGL y otros datos de JavaScript.
El problema radica en la fuente de confianza. El entorno del navegador está controlado por la parte que inicia la solicitud. Por lo tanto, sus afirmaciones no pueden equipararse a hechos confirmados a nivel de hardware. La verificación mediante JavaScript sirve para detectar discrepancias y aumentar la evaluación de riesgo, pero no debe decidir por sí sola si el dispositivo es auténtico y si la identificación es válida. OWASP exige, por separado, una verificación adicional de las condiciones relevantes en el servidor.[3]
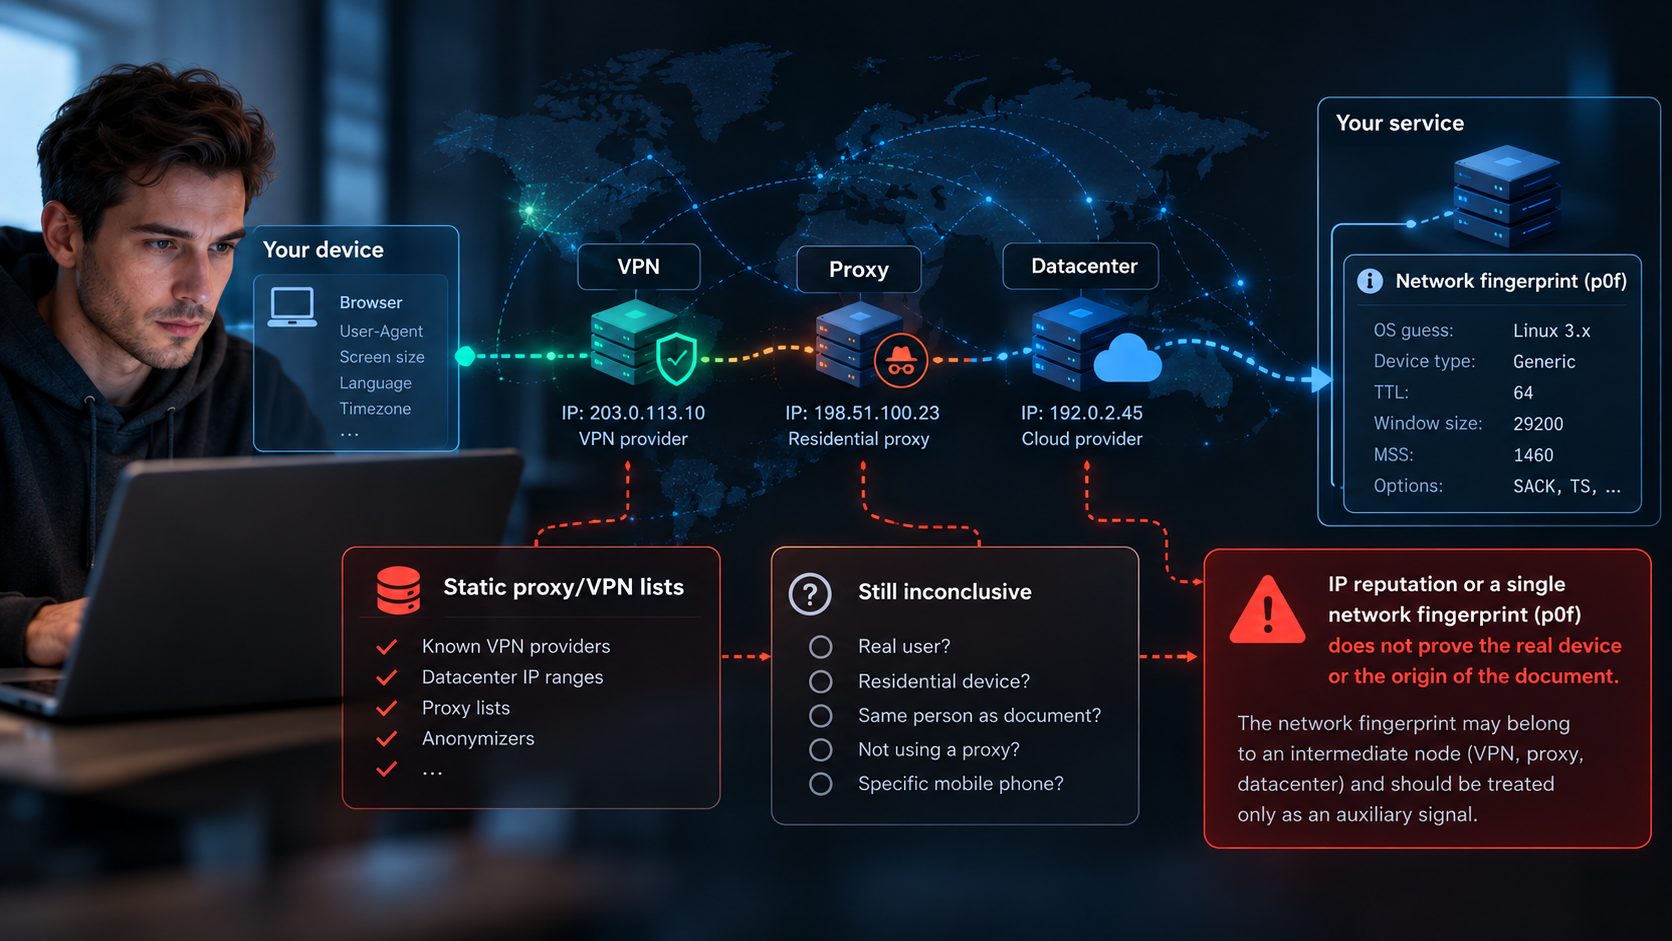
2. Listas estáticas de proxies/VPN y la huella de red única p0f
La reputación de las direcciones IP, las listas de centros de datos, las VPN conocidas, los proxies y los anonimizadores proporcionan indicios útiles, pero no prueban el origen del documento. Las listas estáticas no abarcan todas las rutas de tráfico posibles, y el uso o la ausencia de un proxy no determina por sí solo la buena fe del usuario.
p0f Analiza los indicios pasivos de la pila TCP/IP. No se trata de un mecanismo de certificación de un dispositivo físico. Al trabajar a través de un proxy de aplicación, la huella de red puede corresponder a un nodo intermedio y no al cliente de origen. Los desarrolladores de p0f también recomiendan interpretar el resultado como una señal auxiliar.[4] Una comprobación basada únicamente en la IP o en p0f no permite determinar con certeza que detrás de una solicitud se encuentre un teléfono móvil concreto.
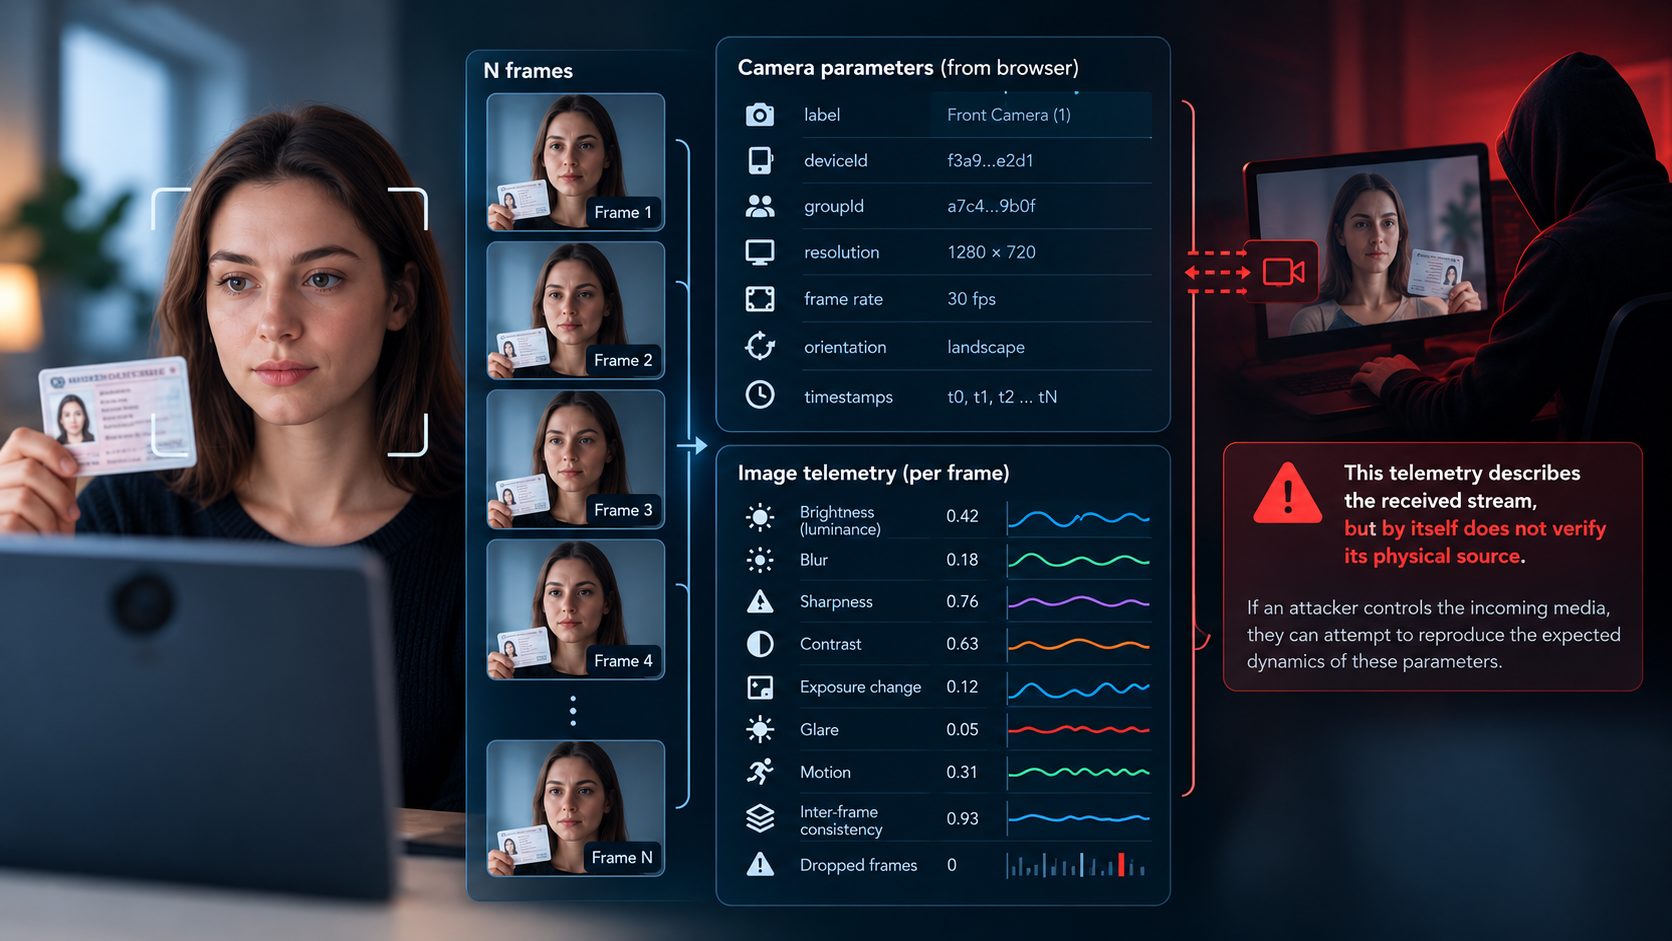
3. Registro de los parámetros de la cámara y de la telemetría en N fotogramas
Durante la grabación, el servicio puede recopilar el nombre de la cámara (label), deviceId, groupId, la resolución, la frecuencia de fotogramas, la orientación de la cámara, las marcas de tiempo y la secuencia de imágenes. A partir de los propios fotogramas se calculan además el brillo (luminance), desenfoque (blur), nitidez, contraste, variaciones de exposición, reflejos, movimiento, coherencia entre fotogramas y omisiones de fotogramas. La disponibilidad de parámetros concretos depende del navegador, el dispositivo y los permisos.[5][6]
Esta telemetría describe el flujo recibido, pero por sí sola no certifica su origen físico. Si un atacante controla el contenido multimedia entrante, puede intentar reproducir la dinámica esperada de los indicadores. La captura de varios fotogramas, el análisis de la iluminación y las consultas sobre el movimiento complican el ataque, pero no sustituyen a la verificación del origen de la señal ni a la protección contra la inyección digital.[2]
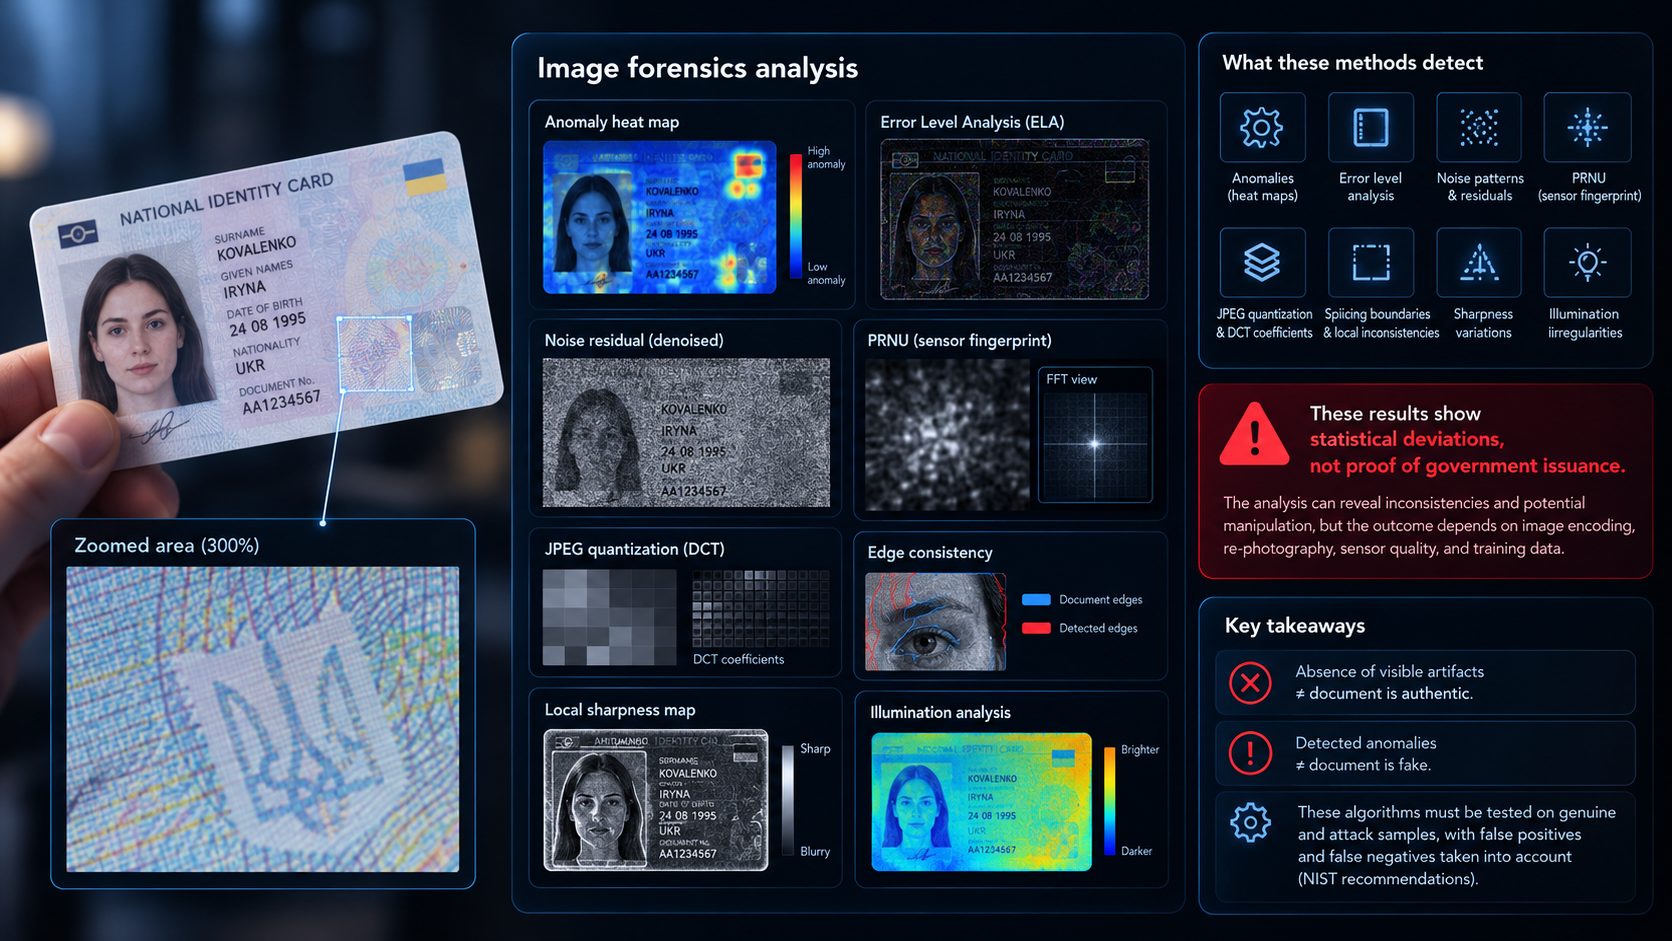
4. Análisis estático de la imagen: mapa de calor, ruido y artefactos
Los algoritmos analizan los mapas de anomalías (heat maps), el análisis de nivel de error, los residuos de ruido, los indicios de PRNU, la cuantificación JPEG, los coeficientes DCT, los límites de las inserciones, los cambios locales de nitidez, la heterogeneidad de la iluminación, la geometría de los caracteres y la coincidencia con la plantilla del documento.
Estos métodos detectan desviaciones estadísticas, no el hecho de que se trate de un documento oficial. El resultado depende de la codificación, la repetición de la captura, la calidad del sensor y la distribución de los datos de entrenamiento. La ausencia de artefactos apreciables no prueba la autenticidad, y una anomalía detectada no siempre implica una falsificación. El NIST exige que dichos algoritmos se comprueben con muestras auténticas y de ataque, y que se tengan en cuenta los falsos positivos y los falsos negativos.[2]
5. Conformidad formal de la MRZ, el código de barras y los datos impresos
Comparación de la zona visual (VIZ) con la zona legible por máquina (MRZ), la verificación de los dígitos de control, las fechas y la estructura de los códigos bidimensionales son imprescindibles. Sin embargo, un dígito de control correcto confirma la coherencia de los datos, pero no que un organismo público haya emitido alguna vez un documento con esos datos.
El error inverso es aún más peligroso: el sistema detecta una discrepancia entre la MRZ y el anverso, pero no bloquea el veredicto positivo. En la norma NIST SP 800-63A-4, la comparación de la MRZ o del código de barras con los datos impresos se incluye expresamente entre los requisitos para la verificación óptica automatizada.[2]
6. Tokens «dinámicos» sin protección contra la reutilización
nonce, el identificador de operación y el desafío de un solo uso solo son útiles cuando el servidor comprueba su validez, su vinculación a la sesión y a la fase del proceso, así como si se han utilizado anteriormente. Una cadena generada aleatoriamente no constituye una protección si puede presentarse repetidamente para diferentes verificaciones.
La protección contra la reutilización debe garantizarse mediante la lógica del servidor y, cuando sea aplicable, mediante la vinculación criptográfica del resultado a una operación concreta. OWASP considera que la reutilización de tokens y el omisión de etapas del proceso son riesgos de la lógica de negocio de la API.[7]
7. «Liveness» y reconocimiento facial como sustituto de la verificación de documentos
La verificación de la presencia de una persona (liveness / PAD) y la comparación del rostro con una fotografía resuelven tareas importantes, pero limitadas. Ni siquiera una coincidencia biométrica satisfactoria establece el hecho de que se haya expedido un documento, ni que la persona cuyo rostro aparece en el documento sea quien dice ser. Además, las pruebas de PAD y la resistencia de toda la cadena a la suplantación digital son tipos de evaluación distintos. La norma ISO/IEC 30107-3:2023 se centra en los ensayos de PAD, pero no aborda la evaluación de la seguridad de todo el sistema de identificación a distancia.[8]
8. Modelos de autoaprendizaje sin protección contra el envenenamiento de datos
Se plantea un riesgo especial cuando el sistema utiliza automáticamente los resultados de las cargas de los usuarios o una retroalimentación poco verificada para modificar los pesos del modelo. Sin una etiquetación fiable, la puesta en cuarentena de nuevos ejemplos, el control de versiones y una validación independiente, un atacante tiene la posibilidad de influir en las decisiones futuras.
Esta clase de amenazas se conoce como data poisoning y el NIST la analiza en detalle en su taxonomía de ataques a los sistemas de aprendizaje automático.[9]
¿Por qué se ha agravado el problema en la era de la IA generativa?
La protección basada únicamente en la secuencia esperada de observaciones es vulnerable a la reproducción: si el servidor recibe un flujo ya generado, no puede considerar automáticamente blur, luminance, el movimiento y los retrasos como pruebas independientes de una grabación real. Las verificaciones deterministas del cliente, con un control suficiente de los datos de entrada, pueden reproducirse con gran precisión en una serie de escenarios.
Esto no significa que cualquier algoritmo pueda eludirse con total seguridad ni que todos los mecanismos de «liveness» sean inútiles. La protección se refuerza con verificaciones impredecibles, la autenticación del sensor, la vinculación de la sesión al servidor, fuentes de datos independientes y la verificación criptográfica. Sin embargo, ninguno de estos factores por sí solo equivale a una prueba de identidad real. La ENISA destaca los ataques mediante inyección digital y medios falsificados como amenazas significativas para la identificación remota.[10]
Lo que hemos detectado en las auditorías realizadas con el permiso de los clientes
En el marco de las investigaciones acordadas con los propietarios de los sistemas, nuestro equipo detectó los siguientes tipos de errores:
- Confianza en el User-Agent. Algunas implementaciones aceptaban la declaración de un navegador móvil sin una verificación independiente suficiente de las características de la conexión y del dispositivo.
- Reutilización de parámetros de seguridad. Los parámetros declarados como «dinámicos» eran aceptados repetidamente por el servidor sin un control adecuado de su ciclo de vida.
- Contaminación del aprendizaje en tiempo real. En un sistema de desarrollo propio, los documentos falsos subidos influían en el circuito de aprendizaje, y las características de dichos ejemplos comenzaron a prevalecer sobre los criterios de referencia registrados anteriormente.
- Ignoramiento de las contradicciones. En una de las implementaciones, la discrepancia entre los datos de la zona legible por máquina y la parte visual del documento no impedía que se tomara una decisión positiva.
Se notificó a las partes responsables y a los fabricantes sobre las deficiencias detectadas. Los casos citados son el resultado de nuestras auditorías privadas, y no un análisis estadístico público del mercado: aquí no se revelan los nombres de los sistemas, el tamaño de la muestra ni los materiales reproducidos. Ilustran errores concretos de diseño y no implican que todos los proveedores presenten las mismas vulnerabilidades.
El principal límite de confianza es la fuente de emisión, no la imagen
Un documento puede tener un aspecto impecable y ser coherente en su contenido, pero contener datos de una persona inexistente o no confirmada por una fuente autorizada. Por lo tanto, el veredicto «no se han detectado indicios de manipulación» no puede sustituirse por el veredicto «identidad confirmada».
Si se dispone de acceso legal y técnico, la verificación debe cotejar los atributos clave y el estado del documento con el registro estatal, la fuente emisora u otra fuente fidedigna o cuya veracidad pueda comprobarse. Para los pasaportes electrónicos existe una vía criptográfica específica: la verificación de la firma digital de los datos del chip y la cadena de confianza DSC → CSCA, descrita por la OACI. Esta confirma el origen y la integridad de los datos firmados, pero por sí sola no sustituye a la verificación del estado actual del documento ni de la relación con el titular.[1][11]
Si no se dispone de acceso a una fuente fiable, el resultado correcto es «no se ha confirmado la autenticidad de la expedición ni el estado actual», y no un «el documento es auténtico» incondicional. La falta de respuesta del registro no prueba, por sí sola, que se trate de una falsificación: el sistema debe distinguir entre una verificación negativa y la imposibilidad de realizar la verificación.
| Nivel | Qué indica | Qué no demuestra |
|---|---|---|
| Entorno del navegador y red | Presencia de indicios de riesgo en la conexión y la sesión | Autenticidad del dispositivo, del documento o de la identidad |
| Cámara, detección de presencia y análisis multimedia | Coherencia del flujo observado e indicios de suplantación | El hecho de que el documento haya sido expedido por el Estado |
| OCR, MRZ, códigos y plantillas | Formato y coherencia interna de los datos | Existencia del registro en el emisor |
| Firma digital y cadena de confianza | Origen e integridad de los datos firmados tras una validación correcta | Estado actual y legalidad del uso por parte del portador |
| Fuente fidedigna y verificación del portador | Confirmación de los atributos disponibles, el estado y la vinculación con la identidad | Ausencia absoluta de fraude en cualquier escenario posterior |
Nuestro enfoque: verificar los fundamentos reales de la confianza, y no solo los indicios indirectos
No evaluamos el sistema por el número de sensores, firmas y algoritmos que aparecen en la presentación, sino por qué afirmación concreta es capaz de demostrar cada verificación y cómo se comporta ante un ataque dirigido. Para el cliente, diseñamos un modelo de protección adaptado a la documentación, la jurisdicción, el escenario de uso y el nivel de riesgo aceptable.
- Niveles de control independientes. Los indicadores del navegador, de red y visuales se tienen en cuenta como señales adicionales de riesgo, y no como prueba independiente.
- Proceso de verificación protegido. Control de las etapas por parte del servidor, carácter único y vinculación del «challenge», detección de repeticiones y protección contra la suplantación digital del flujo de datos.
- Verificación del origen del documento. Comprobación de las pruebas criptográficas admisibles e integración con fuentes oficiales u otras fuentes fidedignas, siempre que sea jurídica y técnicamente posible.
- Protección del circuito de aprendizaje. Almacenamiento separado de las cargas de los usuarios y de las etiquetas de referencia, actualización controlada de los modelos, comprobación de desviaciones en la calidad y posibilidad de revertir los cambios.
- Estabilidad medible. Evaluación de falsas admisiones y desviaciones (incluidas
DFAR/DFRRel análisis de documentos), pruebas de sustitución de flujos, repeticiones, campos contradictorios y nuevos tipos de imágenes sintéticas.
Para nosotros, una verificación rigurosa no es una promesa de «protección al 100 %», sino un procedimiento reproducible con fuentes de confianza claras, métricas verificables y una distinción explícita entre los estados «confirmado», «no confirmado» y «se ha detectado una contradicción».
¿Necesitas protección contra documentos falsos adaptada a tu necesidad?
No existe un filtro universal que sea igual de fiable para todos los documentos y canales de verificación. Si su objetivo es reducir los abusos con documentos falsos, comprobar la solidez del proceso KYC actual o desarrollar una solución privada adaptada a una jurisdicción y un modelo de amenazas concretos, póngase en contacto con nosotros.
Le ayudaremos a identificar en qué puntos el sistema se basa en señales que pueden ser falsificadas, a determinar las fuentes de confianza necesarias y a diseñar una verificación cuya solidez pueda confirmarse mediante pruebas técnicas, y no con promesas de marketing.
Fuentes técnicas
Las fuentes confirman las propiedades técnicas generales, los modelos de amenazas y las normas. Los resultados específicos de nuestras auditorías se describen por separado más arriba.
- NIST SP 800-63A-4 — Identity Proofing Overview. Separación entre el establecimiento de la identidad, la comprobación de credenciales y la verificación del portador; fuentes autorizadas y fiables.
- NIST SP 800-63A-4 — Requisitos de verificación de identidad. Análisis óptico, MRZ, suplantación del flujo de medios, ataques con IA generativa y requisitos de pruebas.
- OWASP — Hoja de referencia sobre validación de entradas. Desconfianza en la validación por parte del cliente y validación obligatoria por parte del servidor.
- p0f — Documentación del proyecto. Finalidad del «fingerprinting» pasivo de TCP/IP y limitaciones del método.
- MDN — MediaDevices.enumerateDevices(). Lista de dispositivos multimedia y restricciones de acceso a sus metadatos.
- MDN — MediaStreamTrack.getSettings(). Parámetros disponibles del flujo multimedia.
- OWASP — REST Security Cheat Sheet. Protección del estado de la API, la secuencia de pasos y los tokens contra la reutilización.
- ISO/IEC 30107-3:2023. Métodos de ensayo y presentación de informes para la detección biométrica de ataques de presentación (PAD).
- NIST AI 100-2e2025 — Aprendizaje automático adversarial. Clasificación de ataques, incluyendo el envenenamiento de datos y modelos.
- ENISA — Verificación remota de la identidad: buenas prácticas (2024). Amenazas a la identificación remota, incluidos los ataques de presentación e inyección digital.
- OACI — Conceptos básicos sobre el pasaporte electrónico. Firmas digitales de los pasaportes electrónicos y la cadena de confianza DSC/CSCA.