Viele Lösungen zur Fernidentifizierung stützen ihre endgültige Entscheidung auf indirekte Anhaltspunkte: die Browserumgebung, den Netzwerk-Fingerabdruck, Kameratelemetriedaten und Bildstatistiken. Diese Daten sind zwar für die Risikobewertung nützlich, bilden jedoch eine schwache Grundlage für den Schutz, wenn das System sie als unabhängigen Authentifizierungsnachweis betrachtet. Mit der Entwicklung generativer KI und Angriffen durch Manipulation des Medienstroms ist der Unterschied zwischen einem glaubwürdigen und einem verifizierten Dokument zu einem entscheidenden Faktor geworden. Diese Bedrohung wird vom NIST und der ENISA gesondert behandelt.[1][2]
Was eine Überprüfung tatsächlich bestätigen sollte
Ein zuverlässiger Prozess unterscheidet drei voneinander unabhängige Fragen:
- Echtheit des Dokuments: Entspricht das vorgelegte Medium oder digitale Zertifikat einem Dokument, das von einer autorisierten Stelle ausgestellt wurde?
- Richtigkeit der Angaben: Werden die Angaben, die Tatsache der Ausstellung und, sofern verfügbar, der aktuelle Status des Dokuments von einer vertrauenswürdigen Quelle bestätigt?
- Zugehörigkeit zum Vorlegenden: Gibt es ausreichende Gründe für die Annahme, dass genau die Person, an die das Dokument ausgestellt wurde, die Überprüfung durchläuft?
Die Übereinstimmung der Felder oder das Fehlen von Anzeichen einer Bildbearbeitung deckt nur einen Teil der ersten Frage ab. NIST SP 800-63A-4 unterscheidet ausdrücklich zwischen der Identitätsfeststellung, der Überprüfung der Echtheit von Zertifikaten und der Bestätigung der Verbindung des Vorlegers mit der angegebenen Identität.[1]
Acht Schwachstellen gängiger Ansätze
1. Vertrauen in JavaScript und die Browserumgebung
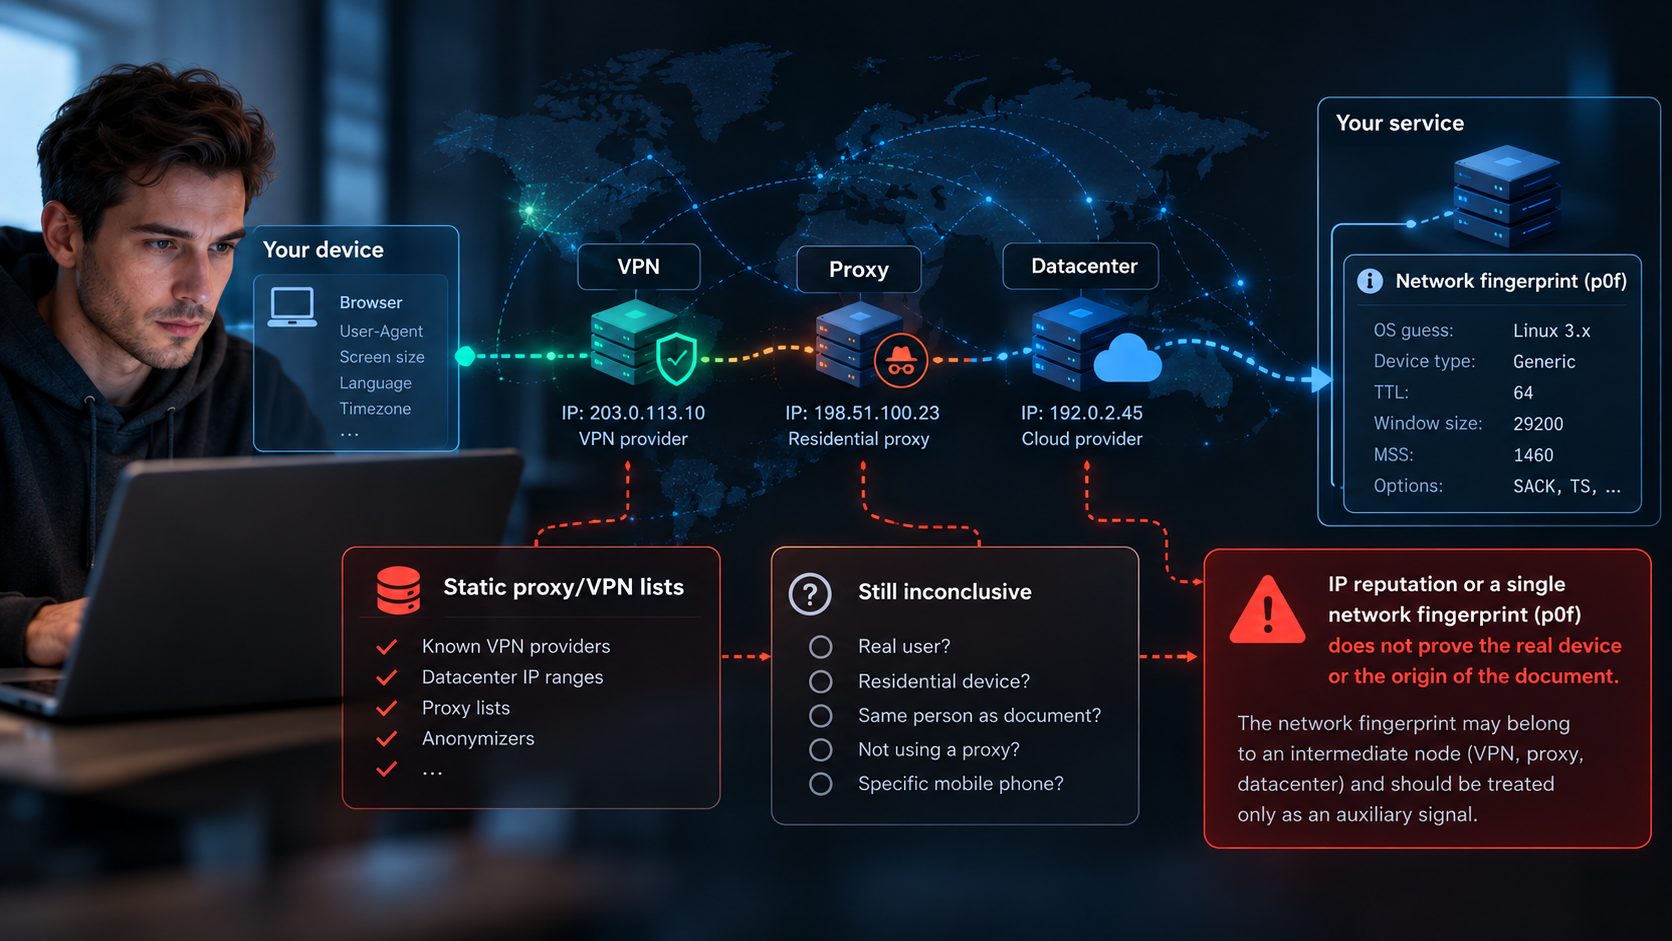
Einige Systeme schließen Rückschlüsse auf den Gerätetyp und die „Natürlichkeit“ einer Sitzung anhand User-Agent, navigator.platform, der Sprache, der Zeitzone, der Touch-Eingabe, den Bildschirmeinstellungen, Canvas-/WebGL-Fingerabdrücken und anderen JavaScript-Daten.
Das Problem ist die Quelle des Vertrauens. Die Browserumgebung wird von der Seite kontrolliert, die die Anfrage initiiert. Daher können ihre Angaben nicht mit hardwaregestützten Fakten gleichgesetzt werden. Die JavaScript-Prüfung eignet sich zur Erkennung von Unstimmigkeiten und zur Erhöhung der Risikoeinschätzung, sollte jedoch nicht eigenständig entscheiden, ob das Gerät echt ist und ob die Identifizierung zulässig ist. OWASP fordert ausdrücklich eine erneute Überprüfung wesentlicher Bedingungen auf dem Server.[3]
2. Statische Proxy-/VPN-Listen und der einzige Netzwerk-Fingerabdruck p0f
IP-Reputation, Listen von Rechenzentren, bekannten VPNs, Proxys und Anonymisierungsdiensten liefern nützliche Hinweise, beweisen jedoch nicht die Herkunft des Dokuments. Statische Listen decken nicht alle möglichen Datenverkehrswege ab, und die Nutzung oder das Fehlen eines Proxys allein sagt nichts über die Seriosität des Nutzers aus.
p0f analysiert passive Merkmale des TCP/IP-Stacks. Es handelt sich hierbei nicht um einen Mechanismus zur Authentifizierung eines physischen Geräts. Bei der Nutzung eines Anwendungs-Proxys kann sich der Netzwerk-Fingerabdruck auf einen Zwischenknoten beziehen und nicht auf den ursprünglichen Client. Die Entwickler von p0f empfehlen zudem, das Ergebnis als ergänzendes Indiz zu betrachten.[4] Eine Überprüfung allein anhand der IP-Adresse oder von p0f reicht nicht aus, um zuverlässig festzustellen, dass hinter einer Anfrage ein bestimmtes Mobiltelefon steht.
3. Aufzeichnung von Kameraparametern und Telemetriedaten über N Bilder
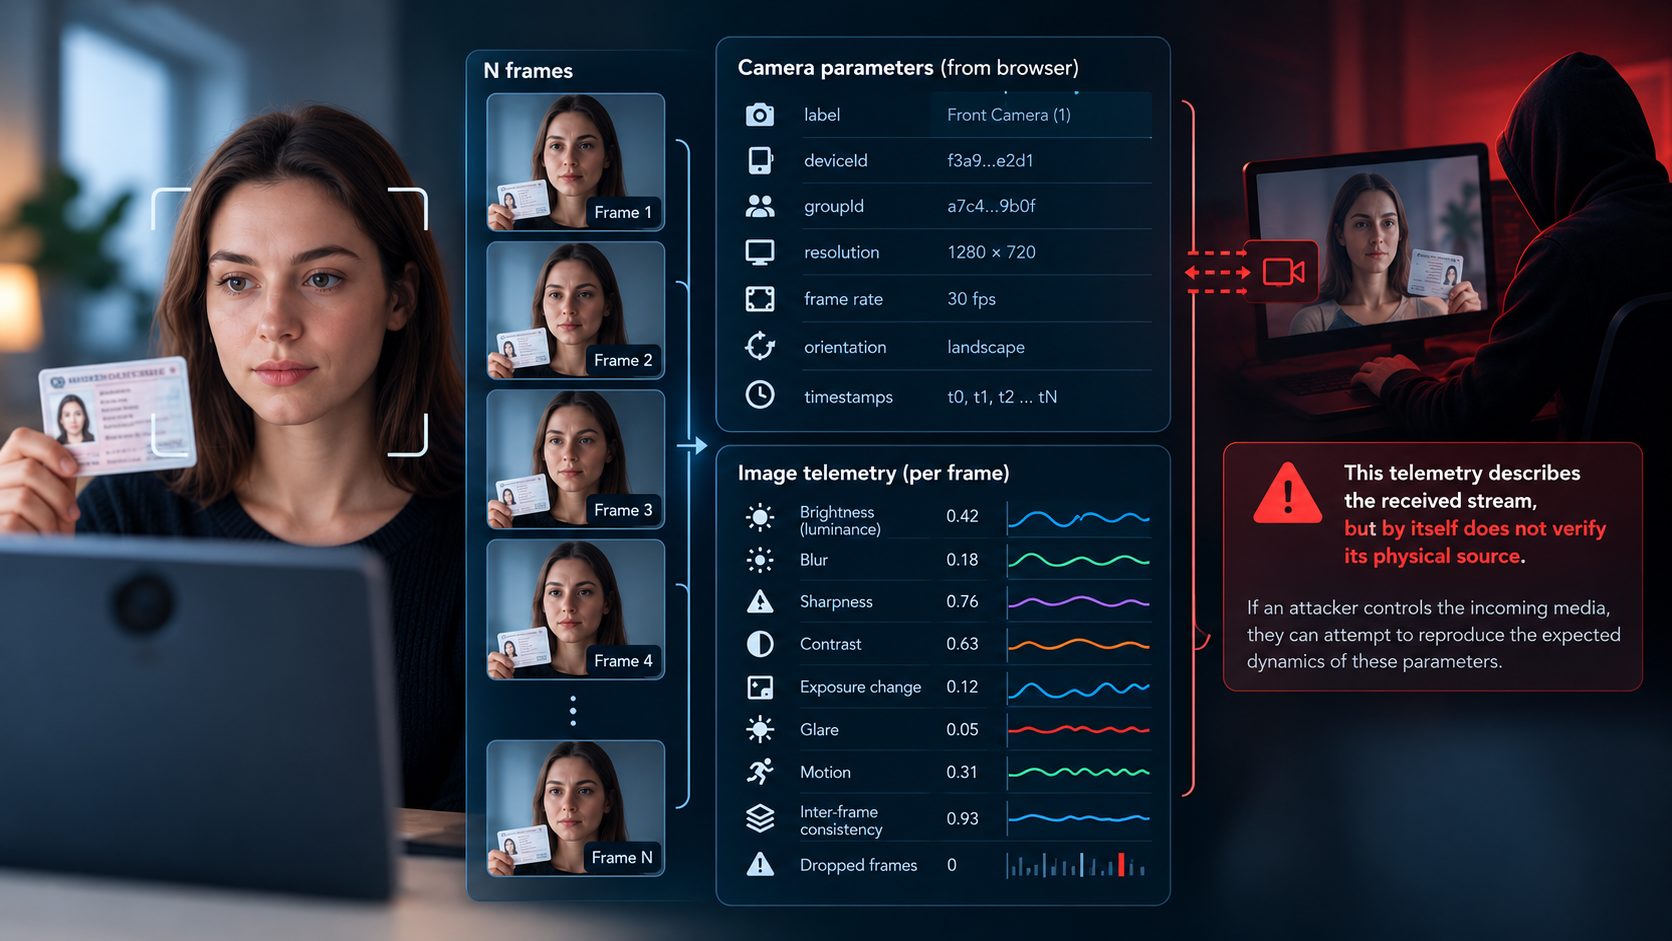
Während der Aufnahme kann der Dienst den Namen der Kamera (label), deviceId, groupId, die Auflösung, die Bildfrequenz, die Kameraausrichtung, Zeitstempel und die Bildsequenz erfassen. Aus den Einzelbildern werden zusätzlich die Helligkeit (luminance), Unschärfe (blur), Schärfe, Kontrast, Belichtungsänderungen, Blendeffekte, Bewegung, Interframe-Kohärenz und Bildausfälle berechnet. Die Verfügbarkeit bestimmter Parameter hängt vom Browser, vom Gerät und von den Berechtigungen ab.[5][6]
Solche Telemetriedaten beschreiben den empfangenen Datenstrom, bestätigen jedoch nicht an sich dessen physikalische Quelle. Wenn ein Angreifer die eingehenden Medien kontrolliert, kann er versuchen, die erwartete Dynamik der Kennzahlen nachzubilden. Die Erfassung mehrerer Frames, die Analyse der Beleuchtung und Bewegungsabfragen erschweren den Angriff, ersetzen jedoch nicht die Überprüfung der Signalherkunft und den Schutz vor digitaler Manipulation.[2]
4. Statische Bildanalyse: Heatmap, Rauschen und Artefakte
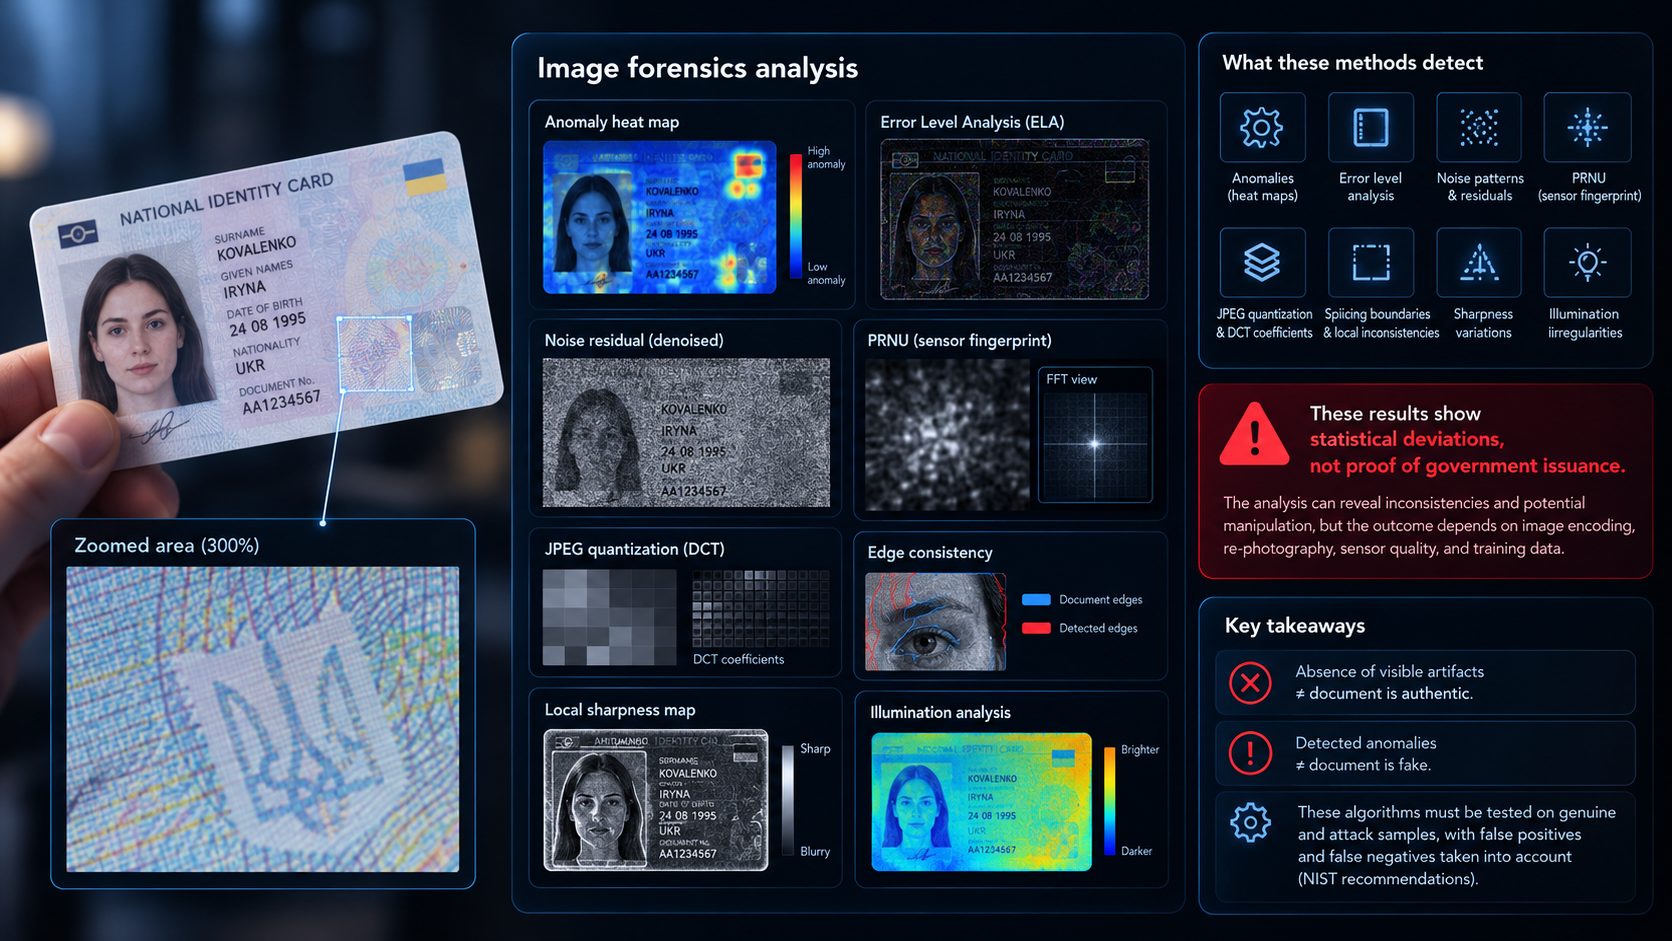
Algorithmen analysieren Anomaliekarten (heat maps), die Fehlerpegelanalyse, Rauschreste, Anzeichen von PRNU, JPEG-Quantisierung, DCT-Koeffizienten, Einfügungsgrenzen, lokale Schärfeänderungen, ungleichmäßige Beleuchtung, die Geometrie der Zeichen und die Übereinstimmung mit der Dokumentvorlage.
Diese Methoden erkennen statistische Abweichungen, nicht jedoch die Tatsache einer behördlichen Ausstellung. Das Ergebnis hängt von der Kodierung, Wiederholungsaufnahmen, der Sensorqualität und der Verteilung der Trainingsdaten ab. Das Fehlen erkennbarer Artefakte beweist keine Echtheit, und eine festgestellte Anomalie bedeutet nicht immer eine Fälschung. Das NIST verlangt, solche Algorithmen anhand von echten und manipulierten Beispielen zu überprüfen und Fehlalarme sowie Auslassungen zu berücksichtigen.[2]
5. Formale Übereinstimmung von MRZ, Barcode und gedruckten Daten
Vergleich des visuellen Bereichs (VIZ) mit dem maschinenlesbaren Bereich (MRZ), die Überprüfung von Prüfziffern, Daten und der Struktur von zweidimensionalen Codes sind erforderlich. Eine korrekte Prüfziffer bestätigt jedoch lediglich die Übereinstimmung der Daten, nicht aber, dass eine staatliche Behörde jemals ein Dokument mit diesen Angaben ausgestellt hat.
Der umgekehrte Fehler ist noch gefährlicher: Das System erkennt eine Abweichung zwischen der MRZ und der Vorderseite, verhindert jedoch nicht die positive Bewertung. In NIST SP 800-63A-4 ist der Abgleich der MRZ oder des Barcodes mit den gedruckten Daten ausdrücklich in den Anforderungen an die automatisierte optische Überprüfung enthalten.[2]
6. „Dynamische“ Tokens ohne Schutz vor Wiederverwendung
nonce, eine Transaktions-ID und eine einmalige Challenge sind nur dann sinnvoll, wenn der Server deren Gültigkeitsdauer, die Verknüpfung mit der Sitzung und der Prozessphase sowie die Tatsache einer vorherigen Verwendung überprüft. Eine zufällig generierte Zeichenfolge stellt keinen Schutz dar, wenn sie mehrfach für verschiedene Überprüfungen vorgelegt werden kann.
Der Schutz vor Wiederverwendung muss durch die Serverlogik und, soweit anwendbar, durch eine kryptografische Verknüpfung des Ergebnisses mit einer bestimmten Operation gewährleistet werden. OWASP betrachtet die Wiederverwendung von Tokens und das Überspringen von Prozessschritten als Risiken der API-Geschäftslogik.[7]
7. Liveness und Gesichtserkennung als Ersatz für die Dokumentenprüfung
Die Überprüfung der Anwesenheit einer Person (liveness / PAD) und der Vergleich des Gesichts mit einem Foto lösen wichtige, aber begrenzte Aufgaben. Selbst ein erfolgreicher biometrischer Abgleich belegt weder die Ausstellung eines Dokuments noch, dass die Person, deren Gesicht auf dem Dokument zu sehen ist, tatsächlich die ist, für die sie sich ausgibt. Darüber hinaus sind PAD-Tests und die Widerstandsfähigkeit der gesamten Kette gegen digitale Manipulation unterschiedliche Arten der Bewertung. ISO/IEC 30107-3:2023 befasst sich mit PAD-Tests, gibt jedoch keine Aussage zur Sicherheitsbewertung des gesamten Systems der Fernidentifizierung ab.[8]
8. Selbstlernende Modelle ohne Schutz vor Datenvergiftung
Ein besonderes Risiko entsteht, wenn das System automatisch die Ergebnisse von Benutzer-Uploads oder nur unzureichend überprüfte Rückmeldungen nutzt, um die Gewichte des Modells anzupassen. Ohne vertrauenswürdige Annotation, Quarantäne neuer Beispiele, Versionskontrolle und unabhängige Validierung erhält ein Angreifer die Möglichkeit, zukünftige Entscheidungen zu beeinflussen.
Diese Klasse von Bedrohungen ist bekannt als data poisoning und wird vom NIST in der Taxonomie der Angriffe auf maschinelle Lernsysteme ausführlich behandelt.[9]
Warum sich das Problem im Zeitalter der generativen KI verschärft hat
Ein Schutz, der ausschließlich auf der erwarteten Abfolge von Beobachtungen basiert, ist anfällig für Reproduktion: Wenn der Server einen bereits generierten Datenstrom empfängt, kann er die gemessenen blur, luminance, die Bewegung und die Verzögerungen nicht automatisch als unabhängige Belege für eine echte Aufnahme erkennen. Deterministische Client-Prüfungen lassen sich bei ausreichender Kontrolle der Eingabedaten in einer Reihe von Szenarien mit hoher Genauigkeit wiederholen.
Das bedeutet nicht, dass jeder Algorithmus garantiert umgangen werden kann oder dass alle Liveness-Mechanismen nutzlos sind. Der Schutz wird durch unvorhersehbare Überprüfungen, die Authentifizierung des Sensors, die serverseitige Bindung der Sitzung, unabhängige Datenquellen und kryptografische Überprüfungen verstärkt. Allerdings ist keiner dieser Faktoren für sich genommen gleichbedeutend mit dem Nachweis einer echten Identität. Die ENISA stuft Angriffe durch digitale Manipulation und gefälschte Medien als erhebliche Bedrohungen für die Fernidentifizierung ein.[10]
Was wir bei Prüfungen mit Zustimmung der Kunden festgestellt haben
Im Rahmen von Untersuchungen, die mit den Systembetreibern abgestimmt wurden, hat unser Team folgende Fehlerklassen festgestellt:
- Vertrauen in den User-Agent. Ein Teil der Implementierungen akzeptierte die Angabe eines mobilen Browsers, ohne die Eigenschaften der Verbindung und des Geräts ausreichend unabhängig zu überprüfen.
- Wiederverwendung von Sicherheitsparametern. Als „dynamisch“ deklarierte Parameter wurden vom Server wiederholt akzeptiert, ohne dass eine ordnungsgemäße Lebenszykluskontrolle stattfand.
- Verfälschung des Live-Learning-Prozesses. In einem selbst entwickelten System beeinflussten hochgeladene gefälschte Dokumente den Trainingsprozess, sodass Merkmale solcher Beispiele gegenüber zuvor festgelegten Referenzkriterien an Bedeutung gewannen.
- Ignorieren von Widersprüchen. In einer der Implementierungen stand die Diskrepanz zwischen den Daten des maschinenlesbaren Bereichs und dem visuellen Teil des Dokuments einer positiven Entscheidung nicht im Wege.
Die verantwortlichen Stellen und Hersteller wurden über die festgestellten Mängel informiert. Die angeführten Fälle sind Ergebnisse unserer eigenen Audits und stellen keine öffentliche statistische Marktübersicht dar: Die Namen der Systeme, der Umfang der Stichprobe und die verwendeten Materialien werden hier nicht offengelegt. Sie veranschaulichen konkrete Konstruktionsfehler und bedeuten nicht, dass alle Anbieter dieselben Schwachstellen aufweisen.
Die wichtigste Vertrauensgrenze ist die Ausstellungsquelle, nicht das Bild
Ein Dokument kann perfekt aussehen und in sich stimmig sein, aber Angaben zu einer nicht existierenden oder von keiner autorisierten Quelle bestätigten Person enthalten. Daher darf das Urteil „keine Anzeichen einer Fälschung festgestellt“ nicht durch das Urteil „Identität festgestellt“ ersetzt werden.
Sofern rechtlicher und technischer Zugriff besteht, muss die Überprüfung die Schlüsselattribute und den Status des Dokuments mit dem staatlichen Register, der ausstellenden Stelle oder einer anderen maßgeblichen bzw. auf ihre Echtheit überprüfbaren Quelle abgleichen. Für elektronische Reisepässe gibt es einen separaten kryptografischen Weg: die Überprüfung der digitalen Signatur der Chipdaten und der Vertrauenskette DSC → CSCA, wie von der ICAO beschrieben. Sie bestätigt die Herkunft und Integrität der signierten Daten, ersetzt jedoch für sich genommen nicht die Überprüfung des aktuellen Status des Dokuments und der Verbindung zum Vorlegenden.[1][11]
Wenn kein Zugriff auf eine zuverlässige Quelle besteht, lautet das korrekte Ergebnis „Echtheit der Ausstellung oder aktueller Status nicht bestätigt“ und nicht bedingungslos „Dokument ist echt“. Das Ausbleiben einer Antwort des Registers beweist dabei keine Fälschung: Das System muss zwischen einer negativen Überprüfung und der Unmöglichkeit einer Überprüfung unterscheiden.
| Stufe | Was sie aussagen | Was sie nicht beweisen |
|---|---|---|
| Browserumgebung und Netzwerk | Vorhandensein von Risikomerkmalen bei Verbindung und Sitzung | Echtheit des Geräts, des Dokuments oder der Identität |
| Kamera, Lebendigkeitsprüfung und Medienanalyse | Übereinstimmung des beobachteten Datenstroms und Anzeichen für eine Manipulation | Tatsache der behördlichen Ausstellung des Dokuments |
| OCR, MRZ, Codes und Vorlagen | Format und interne Übereinstimmung der Angaben | Vorhandensein eines Datensatzes beim Aussteller |
| Digitale Signatur und Vertrauenskette | Herkunft und Integrität der signierten Daten bei korrekter Validierung | Aktueller Status und Rechtmäßigkeit der Nutzung durch den Vorleger |
| Maßgebliche Quelle und Überprüfung des Vorlegers | Bestätigung der verfügbaren Attribute, des Status und der Verbindung zur Identität | Absolute Betrugsfreiheit in jedem weiteren Szenario |
Unser Ansatz: Überprüfung tatsächlicher Vertrauensgrundlagen und nicht nur indirekter Anhaltspunkte
Wir bewerten ein System nicht anhand der Anzahl der Sensoren, Signaturen und Algorithmen in der Präsentation, sondern danach, welche konkrete Aussage jede Überprüfung nachweisen kann und wie sie sich bei einem gezielten Angriff verhält. Für den Kunden entwickeln wir ein Schutzmodell, das auf die jeweiligen Dokumente, Rechtsordnungen, Anwendungsszenarien und das akzeptable Risikoniveau zugeschnitten ist.
- Unabhängige Kontrollebenen. Browser-, Netzwerk- und visuelle Anzeichen werden als zusätzliche Risikosignale berücksichtigt, nicht als eigenständiger Beweis.
- Gesicherter Überprüfungsprozess. Serverbasierte Phasenkontrolle, Einmaligkeit und Bindung der Challenge, Erkennung von Wiederholungen sowie Schutz vor digitaler Manipulation des Datenstroms.
- Verifizierung der Dokumentherkunft. Überprüfung zulässiger kryptografischer Nachweise und Integration mit offiziellen oder anderen maßgeblichen Quellen, soweit dies rechtlich und technisch möglich ist.
- Schutz des Trainingsprozesses. Getrennte Speicherung von Benutzer-Uploads und Referenzmarkierungen, kontrollierte Modellaktualisierung, Überprüfung von Qualitätsabweichungen und Rollback-Möglichkeit.
- Messbare Robustheit. Bewertung von Fehlzulassungen und Abweichungen (einschließlich
DFAR/DFRRfür die Dokumentenanalyse), Tests auf Datenstrommanipulation, Wiederholungen, widersprüchliche Felder und neue Arten synthetischer Bilder.
Für uns bedeutet eine gründliche Überprüfung nicht das Versprechen eines „100-prozentigen Schutzes“, sondern ein reproduzierbares Verfahren mit nachvollziehbaren Vertrauensquellen, überprüfbaren Metriken und einer klaren Unterscheidung zwischen den Zuständen „bestätigt“, „nicht bestätigt“ und „Widerspruch festgestellt“.
Benötigen Sie Schutz vor gefälschten Dokumenten, der auf Ihre Anforderungen zugeschnitten ist?
Einen universellen Filter, der für alle Dokumente und Prüfkanäle gleichermaßen zuverlässig ist, gibt es nicht. Wenn es Ihr Ziel ist, den Missbrauch gefälschter Dokumente einzudämmen, die Robustheit Ihres bestehenden KYC-Prozesses zu überprüfen oder eine maßgeschneiderte Lösung für eine bestimmte Rechtsordnung und ein bestimmtes Bedrohungsszenario zu entwickeln, wenden Sie sich an uns.
Wir helfen Ihnen dabei, aufzudecken, wo sich das System auf nachgeahmte Signale stützt, die erforderlichen Vertrauensquellen zu ermitteln und eine Überprüfung zu konzipieren, deren Robustheit durch technische Tests und nicht durch Marketingversprechen bestätigt werden kann.
Technische Quellen
Die Quellen bestätigen allgemeine technische Eigenschaften, Bedrohungsmodelle und Standards. Die spezifischen Ergebnisse unserer Audits sind oben separat beschrieben.
- NIST SP 800-63A-4 – Identity Proofing Overview. Unterscheidung zwischen Identitätsfeststellung, Überprüfung von Nachweisen und Verifizierung des Vorlegers; maßgebliche und zuverlässige Quellen.
- NIST SP 800-63A-4 – Identity Proofing Requirements. Optische Analyse, MRZ, Manipulation des Medienstreams, Angriffe unter Verwendung generativer KI und Testanforderungen.
- OWASP – Spickzettel zur Eingabevalidierung. Misstrauen gegenüber der clientseitigen Überprüfung und obligatorische Validierung durch den Server.
- p0f – Projektdokumentation. Zweck des passiven TCP/IP-Fingerprintings und Einschränkungen der Methode.
- MDN – MediaDevices.enumerateDevices(). Auflistung von Mediengeräten und Einschränkungen beim Zugriff auf deren Metadaten.
- MDN – MediaStreamTrack.getSettings(). Verfügbare Parameter für Medienströme.
- OWASP – REST Security Cheat Sheet. Schutz des API-Zustands, der Schrittfolge und der Tokens vor Wiederverwendung.
- ISO/IEC 30107-3:2023. Prüf- und Berichtsverfahren für die biometrische Erkennung von Present-Attack-Angriffen (PAD).
- NIST AI 100-2e2025 – Adversarial Machine Learning. Klassifizierung von Angriffen, einschließlich Daten- und Modellvergiftung.
- ENISA – Remote ID Proofing: Good Practices (2024). Bedrohungen bei der Fernidentifizierung, einschließlich Präsentationsangriffen und digitaler Injektion.
- ICAO – Grundlagen zum ePass. Digitale Signaturen in elektronischen Reisepässen und die DSC/CSCA-Vertrauenskette.