Mnohá řešení pro vzdálenou identifikaci zakládají své konečné rozhodnutí na nepřímých znacích: prostředí prohlížeče, síťovém otisku, telemetrických údajích z kamery a statistikách obrazu. Tyto údaje jsou užitečné pro hodnocení rizika, ale stávají se slabým základem ochrany, pokud je systém považuje za nezávislé potvrzení pravosti. S rozvojem generativní umělé inteligence a útoků založených na manipulaci mediálního toku se rozdíl mezi věrohodným a ověřeným dokumentem stal zásadním. Tuto hrozbu samostatně zkoumají organizace NIST a ENISA.[1][2]
Co by měla kontrola ve skutečnosti ověřovat
Spolehlivý proces rozlišuje tři nezávislé otázky:
- Pravost dokumentu: odpovídá předložený nosič nebo digitální certifikát dokumentu vydanému oprávněným zdrojem?
- Platnost údajů: potvrzuje důvěryhodný zdroj údaje, skutečnost vydání a, je-li to možné, aktuální stav dokumentu?
- Příslušnost k předkladateli: existují dostatečné důvody se domnívat, že ověření prochází právě ta osoba, které byl dokument vydán?
Shoda polí nebo absence známek úpravy obrázku pokrývá pouze část první otázky. NIST SP 800-63A-4 výslovně rozlišuje mezi ověřením totožnosti, ověřením pravosti certifikátů a potvrzením souvislosti předkladatele s deklarovanou totožností.[1]
Osm slabých míst běžných přístupů
1. Důvěra v JavaScript a prostředí prohlížeče
Některé systémy vyvozují závěry o typu zařízení a „přirozenosti“ relace na základě User-Agent, navigator.platform, jazyku, časovém pásmu, dotykovému vstupu, parametrům obrazovky, otiskům Canvas/WebGL a dalším údajům z JavaScriptu.
Problémem je zdroj důvěry. Prostředí prohlížeče je kontrolováno stranou, která iniciuje požadavek. Proto nelze její tvrzení považovat za fakta potvrzená na hardwarové úrovni. Kontrola pomocí JavaScriptu je vhodná pro vyhledávání nesrovnalostí a zvýšení hodnocení rizika, ale neměla by sama o sobě rozhodovat o tom, zda je zařízení skutečné a zda je identifikace přípustná. OWASP zvlášť vyžaduje opakovanou kontrolu významných podmínek na serveru.[3]
2. Statické seznamy proxy/VPN a jediný síťový otisk p0f
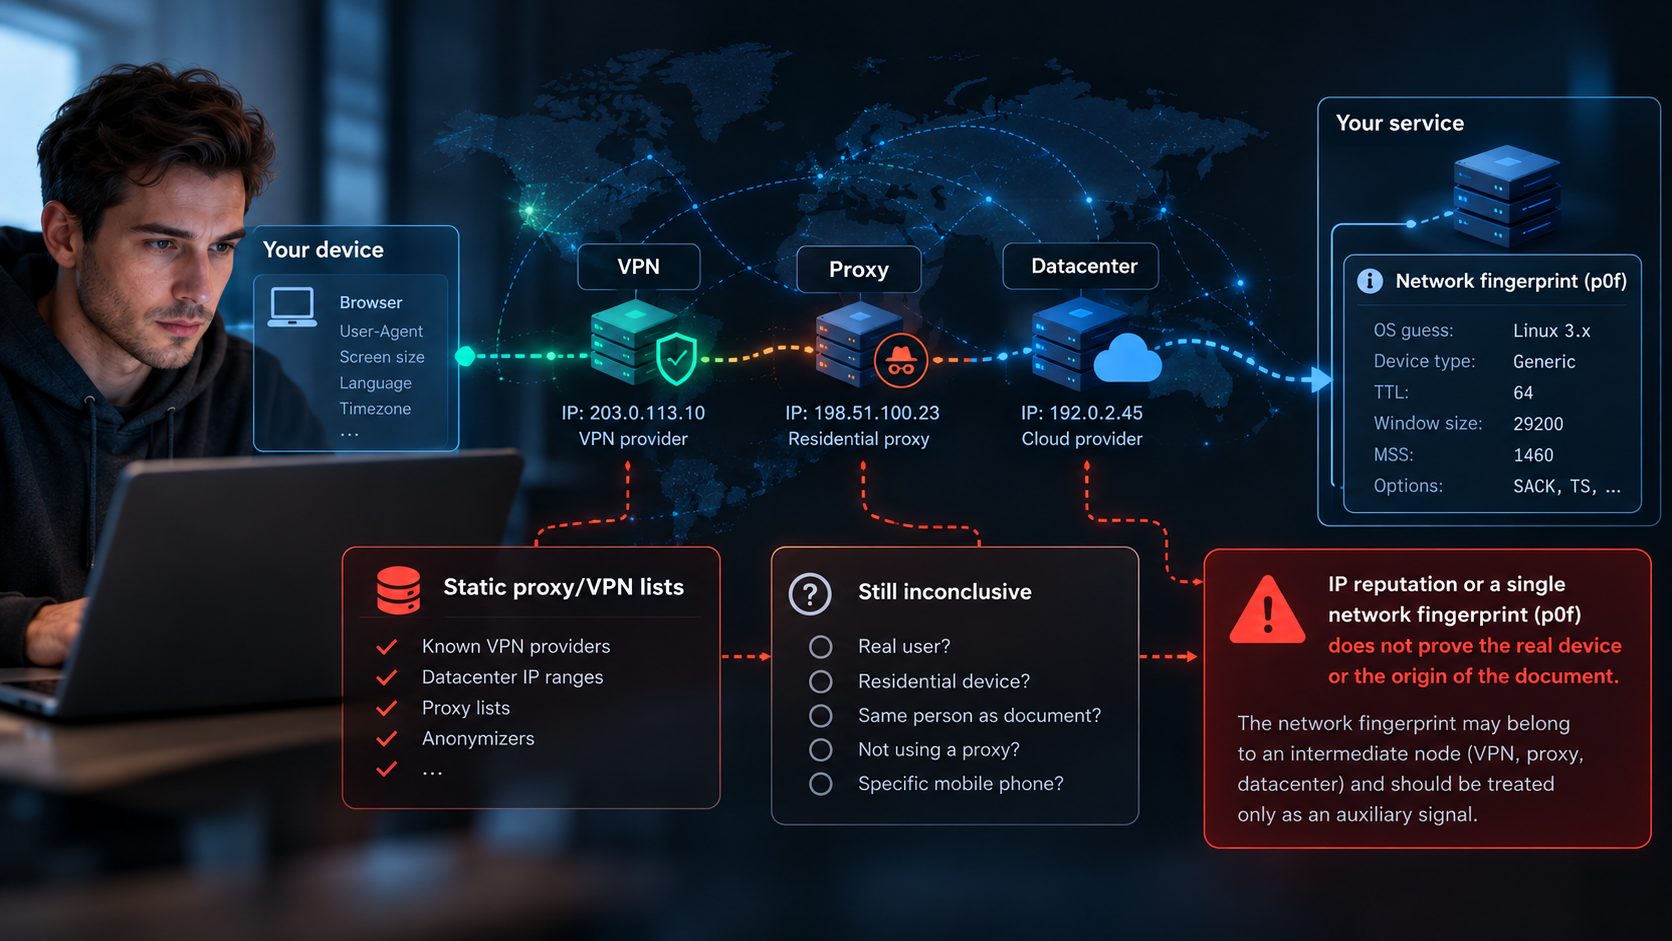
IP reputace, seznamy datových center, známých VPN, proxy a anonymizátorů poskytují užitečné signály, ale nedokazují původ dokumentu. Statické seznamy nepokrývají všechny možné trasy provozu a použití či absence proxy samo o sobě neurčuje poctivost uživatele.
p0f Analyzuje pasivní znaky TCP/IP stacku. Nejedná se o mechanismus ověřování fyzického zařízení. Při práci přes aplikační proxy se síťový otisk může vztahovat k mezilehlému uzlu, nikoli k původnímu klientovi. Vývojáři p0f rovněž doporučují považovat výsledek za pomocný signál.[4] Kontrola pouze na základě IP adresy nebo p0f není schopna spolehlivě určit, že za požadavkem stojí konkrétní mobilní telefon.
3. Záznam parametrů kamery a telemetrie na základě N snímků
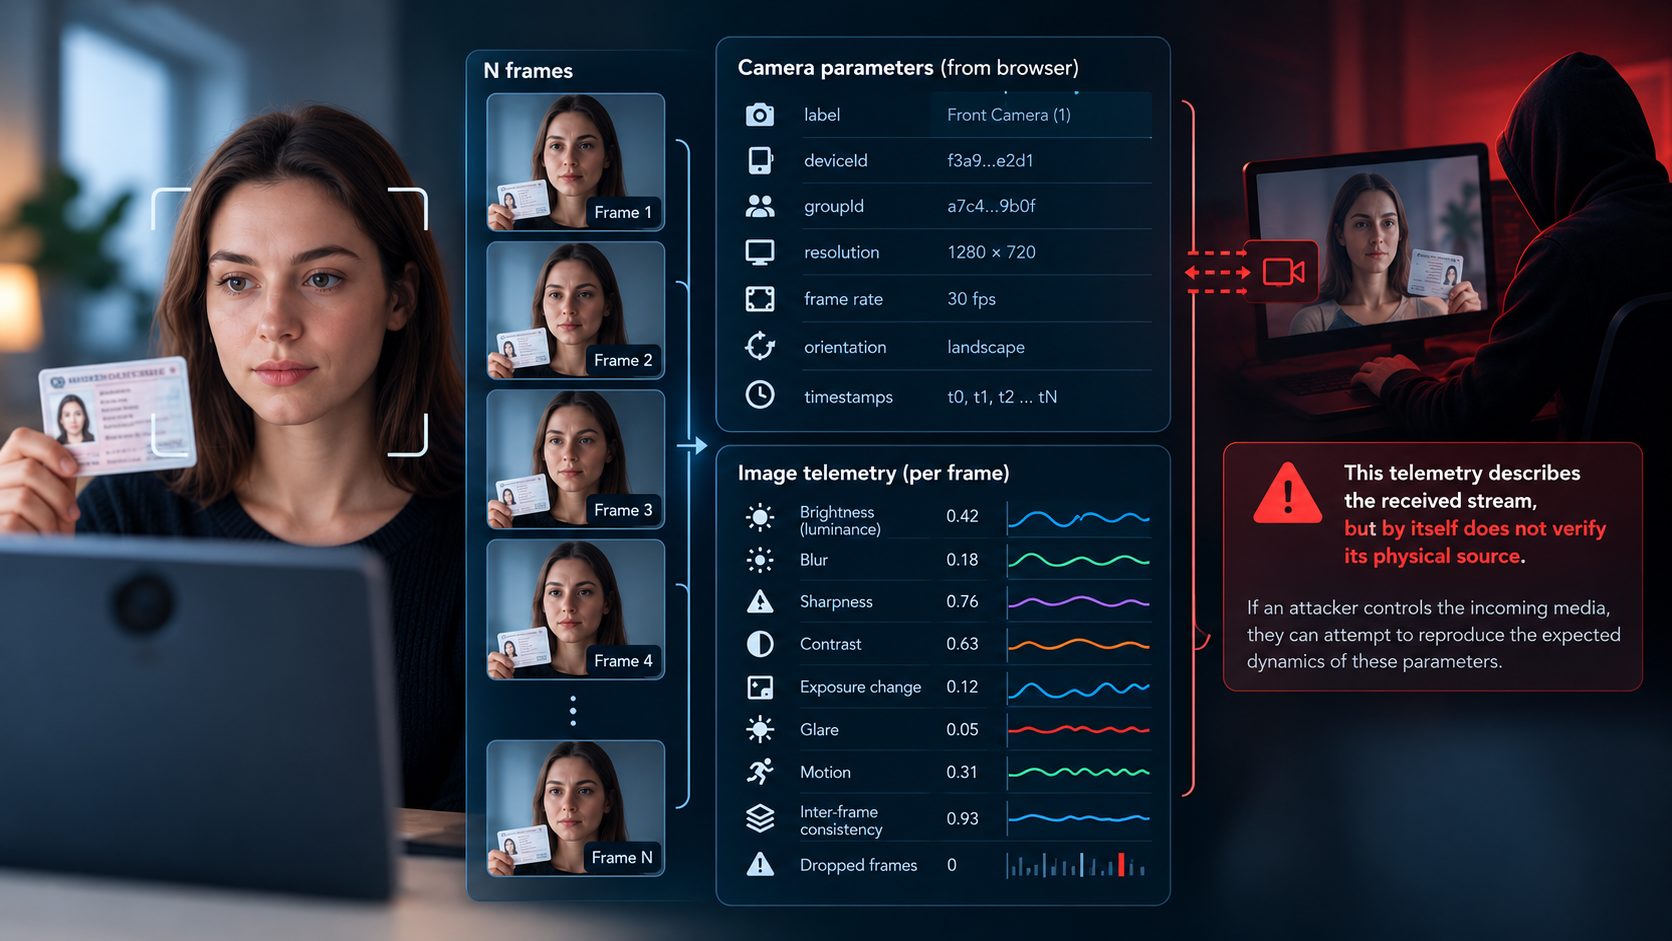
Během natáčení může služba shromažďovat název kamery (label), deviceId, groupId, rozlišení, snímkovou frekvenci, orientaci kamery, časové značky a pořadí snímků. Ze samotných snímků se navíc vypočítává jas (luminance), rozmazání (blur), ostrost, kontrast, změny expozice, odlesky, pohyb, mezisnímkovou souladnost a vynechané snímky. Dostupnost konkrétních parametrů závisí na prohlížeči, zařízení a oprávněních.[5][6]
Taková telemetrie popisuje přijatý datový tok, ale sama o sobě neověřuje jeho fyzický zdroj. Pokud útočník ovládá příchozí mediální data, může se pokusit napodobit očekávanou dynamiku těchto ukazatelů. Zachycení několika snímků, analýza osvětlení a dotazy na pohyb útok zkomplikují, nenahrazují však ověření původu signálu a ochranu před digitální injekcí.[2]
4. Statická analýza obrazu: teplotní mapa, šum a artefakty
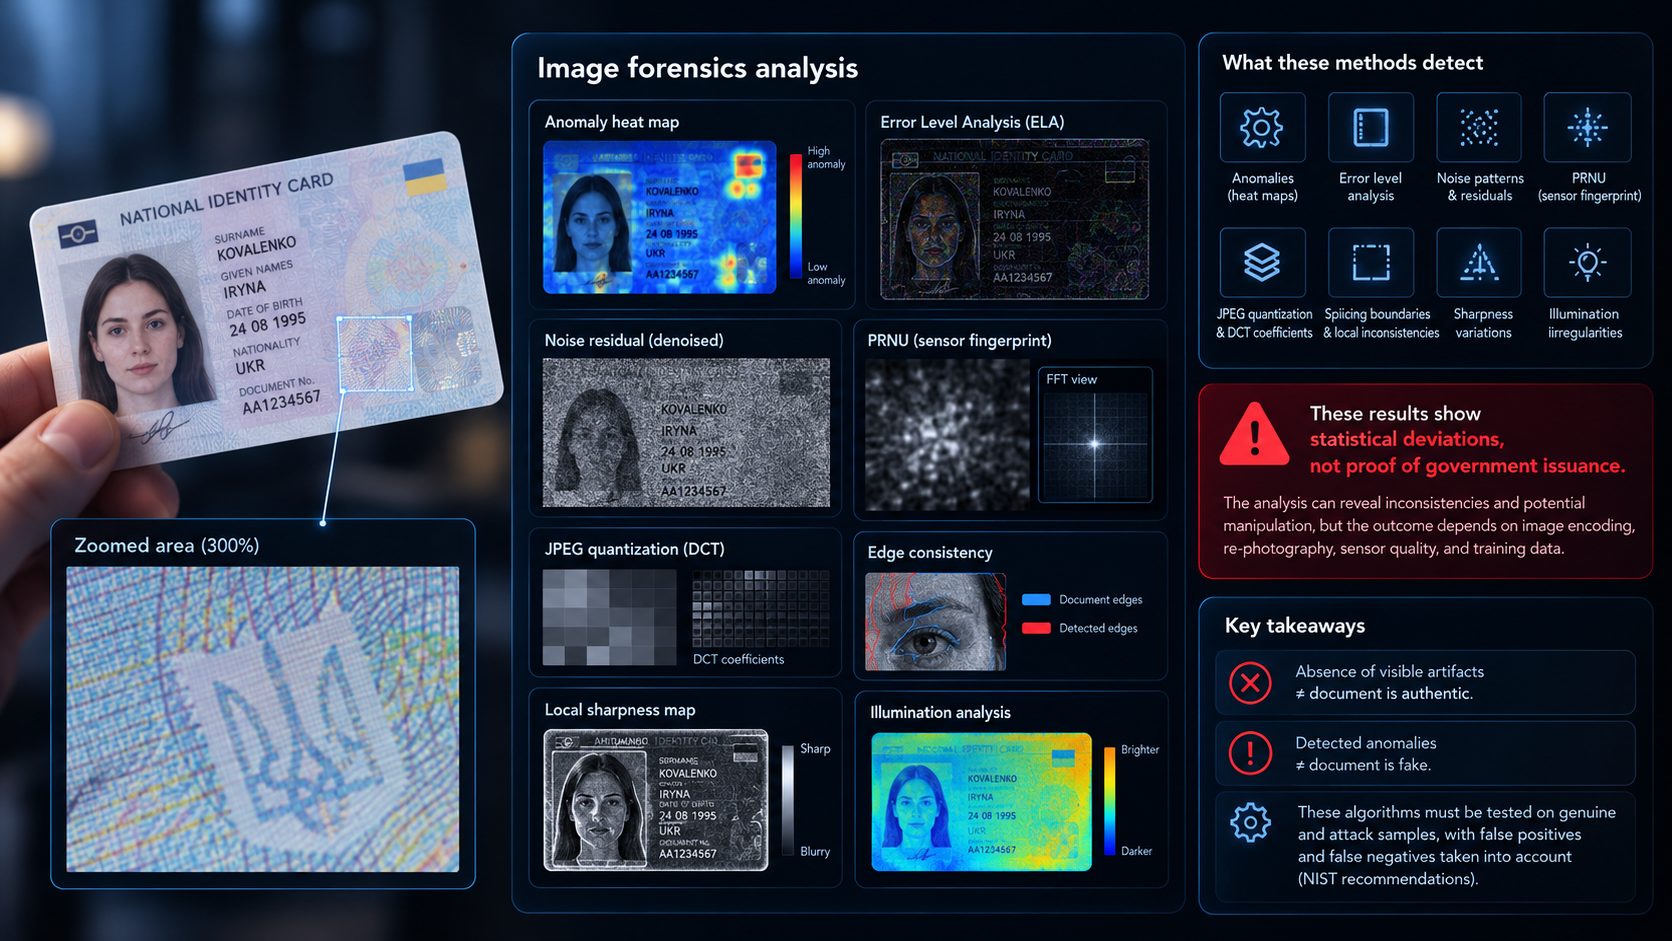
Algoritmy analyzují mapy anomálií (heat maps), analýzu úrovně chyb (Error Level Analysis), zbytkový šum, znaky PRNU, JPEG kvantizaci, DCT koeficienty, hranice vložených částí, lokální změny ostrosti, nerovnoměrnost osvětlení, geometrii symbolů a shodu se šablonou dokumentu.
Tyto metody odhalují statistické odchylky, nikoli skutečnost, že se jedná o státní doklad. Výsledek závisí na kódování, opakovaném snímání, kvalitě snímače a rozložení trénovacích dat. Absence viditelných artefaktů neprokazuje pravost, zatímco zjištěná anomálie nemusí vždy znamenat padělek. NIST vyžaduje, aby byly tyto algoritmy testovány na autentických i útočných vzorcích a aby byly zohledněny falešné poplachy i opomenutí.[2]
5. Formální shoda MRZ, čárového kódu a tištěných údajů
Porovnání vizuální zóny (VIZ) s strojově čitelnou zónou (MRZ), kontrola kontrolních čísel, dat a struktury dvourozměrných kódů jsou nezbytné. Správné kontrolní číslo však potvrzuje soulad údajů, nikoli to, že státní orgán někdy vydal dokument s těmito údaji.
Opačná chyba je ještě nebezpečnější: systém zaznamená nesoulad mezi MRZ a přední stranou, ale nezablokuje kladný verdikt. V normě NIST SP 800-63A-4 je porovnání MRZ nebo čárového kódu s tištěnými údaji přímo zahrnuto do požadavků na automatizovanou optickou kontrolu.[2]
6. „Dynamické“ tokeny bez ochrany proti opakovanému použití
nonce, identifikátor operace a jednorázový challenge jsou užitečné pouze tehdy, pokud server ověřuje jejich platnost, vazbu na relaci a fázi procesu, jakož i skutečnost předchozího použití. Náhodně vygenerovaný řetězec nepředstavuje ochranu, pokud jej lze opakovaně předkládat pro různé ověřovací účely.
Ochrana proti opakovanému použití musí být zajištěna logikou na straně serveru a, kde je to možné, kryptografickým svázáním výsledku s konkrétní operací. OWASP považuje opakované použití tokenů a vynechání fází procesu za rizika obchodní logiky API.[7]
7. Liveness a rozpoznávání obličeje jako náhrada za ověření dokladu
Ověření přítomnosti osoby (liveness / PAD) a porovnání obličeje s fotografií řeší důležité, avšak omezené úkoly. Ani úspěšné biometrické porovnání neprokazuje skutečnost, že byl doklad vydán, ani to, že osoba, jejíž obličej je na dokladu, je skutečně tou, za kterou se vydává. Kromě toho jsou testování PAD a odolnost celého řetězce proti digitální záměně různé druhy hodnocení. Norma ISO/IEC 30107-3:2023 se věnuje testování PAD, ale neposkytuje hodnocení bezpečnosti celého systému vzdálené identifikace.[8]
8. Samoučící se modely bez ochrany proti datovému otrávení
Zvláštní riziko vzniká, když systém automaticky využívá výsledky uživatelských nahrávek nebo nedostatečně ověřenou zpětnou vazbu ke změně vah modelu. Bez důvěryhodného označování, karantény nových příkladů, správy verzí a nezávislé validace získává útočník možnost ovlivňovat budoucí rozhodnutí.
Tato třída hrozeb je známá jako data poisoning a podrobně se jím zabývá NIST v taxonomii útoků na systémy strojového učení.[9]
Proč se tento problém v éře generativní umělé inteligence ještě více vyhrotil
Ochrana založená pouze na očekávané posloupnosti pozorování je zranitelná vůči reprodukci: pokud server obdrží již vytvořený datový tok, nemůže automaticky považovat naměřené blur, luminance, pohyb a zpoždění za nezávislé důkazy skutečného záznamu. Deterministické klientské kontroly lze při dostatečné kontrole vstupních dat v řadě scénářů zopakovat s vysokou přesností.
To neznamená, že jakýkoli algoritmus lze zaručeně obejít nebo že všechny mechanismy ověřování živosti jsou k ničemu. Ochrana se zvyšuje díky nepředvídatelným ověřením, potvrzení autenticity senzoru, serverovému vázání relace, nezávislým zdrojům dat a kryptografickému ověření. Žádný z těchto faktorů však sám o sobě nestačí jako důkaz skutečné identity. ENISA označuje útoky s digitální injekcí a falešnými médii za významné hrozby pro vzdálenou identifikaci.[10]
Co jsme zjistili při testech s povolením zákazníků
V rámci testů provedených po dohodě s vlastníky systémů zaznamenal náš tým následující typy chyb:
- Důvěra v User-Agent. Část implementací přijímala tvrzení o mobilním prohlížeči bez dostatečné nezávislé kontroly charakteristik připojení a zařízení.
- Opakované použití bezpečnostních parametrů. Parametry deklarované jako „dynamické“ byly serverem přijímány opakovaně bez náležité kontroly jejich životního cyklu.
- Znehodnocení procesu live-learning. V jednom vlastním systému ovlivňovaly nahrané falešné dokumenty učící smyčku a znaky těchto vzorků začaly mít přednost před dříve zaznamenanými referenčními kritérii.
- Ignorování rozporů. V jedné z implementací nesoulad mezi údaji v strojově čitelné zóně a vizuální částí dokumentu nebránil kladnému rozhodnutí.
O zjištěných nedostatcích byly informovány odpovědné strany a výrobci. Uvedené případy jsou výsledky našich soukromých auditů, nikoli veřejný statistický průřez trhem: názvy systémů, velikost vzorku a reprodukované materiály zde nejsou zveřejňovány. Ilustrují konkrétní chyby v návrhu a neznamenají, že všichni dodavatelé vykazují stejné slabiny.
Hlavní hranicí důvěryhodnosti je zdroj vydání, nikoli samotný obrázek
Dokument může vypadat dokonale a být vnitřně konzistentní, ale může obsahovat údaje o neexistující osobě nebo o osobě, jejíž totožnost nebyla potvrzena autorizovaným zdrojem. Proto nelze verdikt „nebyly zjištěny známky manipulace“ zaměňovat za verdikt „totožnost byla ověřena“.
Je-li k dispozici zákonný a technický přístup, musí kontrola porovnat klíčové atributy a status dokumentu se státním registrem, vydávajícím orgánem nebo jiným autoritativním či ověřitelně důvěryhodným zdrojem. Pro elektronické pasy existuje samostatný kryptografický postup: ověření digitálního podpisu dat čipu a řetězce důvěry DSC → CSCA, popsaný organizací ICAO. Potvrzuje původ a integritu podepsaných údajů, ale sama o sobě nenahrazuje ověření aktuálního stavu dokladu a vztahu k předkladateli.[1][11]
Pokud není k dispozici spolehlivý zdroj, správným výsledkem je „pravost vydání nebo aktuální stav nebyly potvrzeny“, a nikoli bezvýhradné „doklad je pravý“. Absence odpovědi z registru přitom neprokazuje padělání: systém musí rozlišovat mezi negativním výsledkem ověření a nemožností ověření.
| Úroveň | Co ukazuje | Co neprokazuje |
|---|---|---|
| Prostředí prohlížeče a síť | Přítomnost rizikových znaků připojení a relace | Pravost zařízení, dokumentu nebo identity |
| Kamera, ověření živosti a analýza médií | Shoda pozorovaného toku a známky manipulace | Skutečnost, že dokument byl vydán státem |
| OCR, MRZ, kódy a šablony | Formát a vnitřní soulad údajů | Existence záznamu u vydavatele |
| Digitální podpis a důvěryhodný řetězec | Původ a integrita podepsaných dat při správné validaci | Aktuální stav a zákonnost použití předkladatelem |
| Autoritativní zdroj a ověření předkladatele | Potvrzení dostupných atributů, stavu a vazby na osobu | Absolutní absence podvodů v jakémkoli dalším scénáři |
Náš přístup: ověřování skutečných důvodů pro důvěru, nikoli pouze nepřímých znaků
Systém nehodnotíme podle počtu senzorů, signatur a algoritmů uvedených v prezentaci, ale podle toho, jaké konkrétní tvrzení je každá kontrola schopna prokázat a jak se chová při cíleném útoku. Pro zákazníka sestavujeme model ochrany na základě dokumentů, jurisdikcí, scénáře použití a přijatelné míry rizika.
- Nezávislé úrovně kontroly. Prvky v prohlížeči, síti a vizuální znaky jsou zohledňovány jako doplňkové signály rizika, nikoli jako samostatný důkaz.
- Zabezpečený proces ověřování. Serverová kontrola jednotlivých fází, jednorázovost a vazba na výzvu (challenge), detekce opakování a ochrana proti digitální manipulaci datového toku.
- Ověření původu dokumentu. Kontrola přípustných kryptografických důkazů a integrace s oficiálními či jinými autoritativními zdroji tam, kde je to právně a technicky možné.
- Ochrana trénovacího okruhu. Oddělené ukládání uživatelských dat a referenčního formátování, kontrolovaná aktualizace modelů, kontrola odchylek kvality a možnost vrácení do předchozího stavu.
- Měřitelná odolnost. Hodnocení falešných předpokladů a odchylek (včetně
DFAR/DFRRanalýzu dokumentů), testy na záměnu datového toku, opakování, protichůdná pole a nové typy syntetických obrázků.
Pro nás silná kontrola neznamená slib „100% ochrany“, ale reprodukovatelný postup s jasnými zdroji důvěryhodnosti, ověřitelnými metrikami a jasným rozlišením stavů „potvrzeno“, „nepotvrzeno“ a „zjištěn rozpor“.
Potřebujete ochranu před padělanými dokumenty přizpůsobenou vašim potřebám?
Univerzální filtr, který by byl stejně spolehlivý pro všechny dokumenty a kanály ověřování, neexistuje. Pokud je vaším cílem omezit zneužívání falešných dokumentů, ověřit odolnost stávajícího KYC procesu nebo vytvořit vlastní řešení pro konkrétní jurisdikci a model hrozeb, obraťte se na nás.
Pomůžeme vám odhalit, kde se systém spoléhá na napodobené signály, určit nezbytné důvěryhodné zdroje a navrhnout ověřovací proces, jehož odolnost lze potvrdit technickým testováním, nikoli marketingovými sliby.
Technické zdroje
Zdroje potvrzují obecné technické vlastnosti, modely hrozeb a standardy. Konkrétní výsledky našich auditů jsou popsány výše samostatně.
- NIST SP 800-63A-4 — Identity Proofing Overview. Rozlišení mezi identifikací, ověřením dokladů a ověřením předkladatele; autoritativní a důvěryhodné zdroje.
- NIST SP 800-63A-4 — Identity Proofing Requirements. Optická analýza, MRZ, manipulace s mediálním tokem, útoky využívající generativní AI a požadavky na testování.
- OWASP — Input Validation Cheat Sheet. Nedůvěra v ověřování na straně klienta a povinná validace na straně serveru.
- p0f — dokumentace projektu. Účel pasivního TCP/IP fingerprintingu a omezení této metody.
- MDN — MediaDevices.enumerateDevices(). Seznam mediálních zařízení a omezení přístupu k jejich metadatům.
- MDN — MediaStreamTrack.getSettings(). Dostupné parametry mediálního proudu.
- OWASP — REST Security Cheat Sheet. Ochrana stavu API, pořadí kroků a tokenů před opakovaným použitím.
- ISO/IEC 30107-3:2023. Zkušební metody a podávání zpráv pro biometrickou detekci útoků typu „presentation attack“ (PAD).
- NIST AI 100-2e2025 — Adversarial Machine Learning. Klasifikace útoků, včetně otravy dat a modelů.
- ENISA — Remote ID Proofing: Good Practices (2024). Hrozby vzdálené identifikace, včetně útoků typu „presentation“ a digitální injekce.
- ICAO — ePassport Basics. Digitální podpisy elektronických pasů a řetězec důvěry DSC/CSCA.