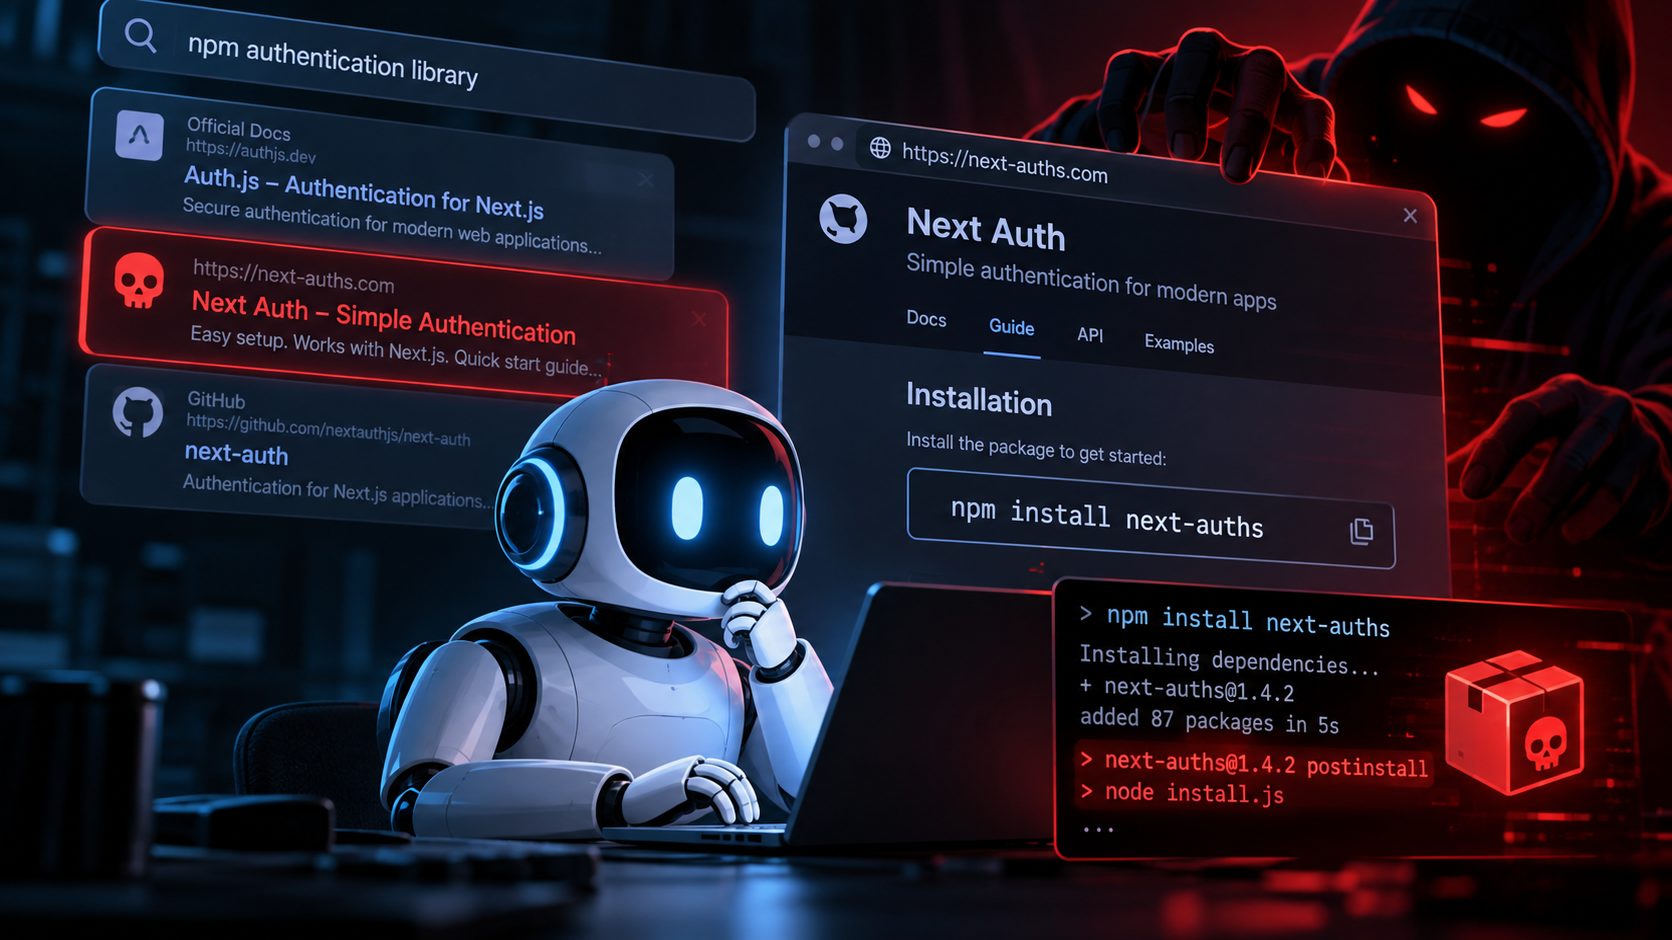
ИИ-агенты всё чаще самостоятельно ищут документацию, выбирают библиотеки и устанавливают зависимости. Злоумышленникам больше не обязательно обманывать разработчика: иногда достаточно повлиять на информацию, которую прочитает его цифровой помощник.
Вы попросили ИИ написать код. Кто выбирает, что он установит?
Представим обычную ситуацию. Разработчик поручает ИИ-агенту добавить авторизацию в веб-приложение. Агент анализирует проект, обращается к поиску, изучает документацию нескольких библиотек и выбирает подходящее решение.
Затем он устанавливает необходимый npm-пакет, обновляет зависимости и продолжает работу.
Задача выполнена. Разработчик доволен: вместо нескольких часов изучения документации всё заняло считаные минуты.
Но есть проблема.
Что, если найденная агентом документация принадлежала злоумышленнику? Или официальный сайт рекомендовал пакет, название которого уже зарегистрировал атакующий?
В таком случае ИИ-агент способен самостоятельно загрузить и выполнить вредоносный код, даже если исходный запрос пользователя был совершенно безобидным.
Эта угроза находится на пересечении нескольких техник: SEO poisoning, indirect prompt injection и атак на цепочку поставок программного обеспечения.
В 2026 году исследователи уже зафиксировали реальные примеры подобных сценариев.
Как отравляют поисковую выдачу для ИИ
Традиционный SEO poisoning — техника, при которой злоумышленник добивается появления подконтрольного ресурса в результатах поиска по определённым запросам.
Раньше основными целями были люди. Пользователь искал популярную программу, переходил на поддельный сайт и скачивал заражённый установщик.
С появлением ИИ-ассистентов возник ещё один потенциальный получатель таких результатов — автономный агент.
Условная цепочка выглядит следующим образом:
- Пользователь поручает ИИ-агенту решить задачу.
- Агент обращается к поиску за документацией.
- В результатах оказывается подконтрольный атакующему источник.
- Источник рекомендует установить определённую библиотеку.
- ИИ-агент устанавливает предложенный пакет.
- Во время установки или использования пакета выполняется вредоносный код.
При этом злоумышленнику не требуется контролировать саму языковую модель.
Достаточно получить влияние на источник информации, который модель использует для принятия решений.
Например, это может быть статья с инструкцией по интеграции API, страница документации SDK, README публичного репозитория или результат поискового инструмента.
Вредоносный материал может выглядеть совершенно обычно: описание возможностей библиотеки, примеры кода, инструкция по настройке и команда установки.
Дополнительную убедительность создают технические детали, упоминания известных технологий и соответствие запросу разработчика.
Для человека такая страница остаётся документацией. Для агента с правом выполнять команды она может стать основанием для запуска установки.
Высокая позиция в поисковой выдаче подтверждает релевантность страницы запросу, но не её безопасность.
Та же проблема возникает, когда ИИ-ассистент получает ответ поискового API и принимает содержимое найденной страницы за достоверное руководство к действию.
Prompt injection: когда инструкция спрятана в данных
Ещё один механизм — indirect prompt injection, или косвенное внедрение инструкций.
В отличие от обычного запроса пользователя, атакующий размещает инструкцию во внешнем материале, который агент должен прочитать в процессе работы.
Таким материалом может быть веб-страница, результат поиска, Markdown-файл, README или ответ стороннего инструмента.
Предположим, ИИ ищет способ подключить библиотеку для обработки документов. На найденной странице указано, что для корректной работы интеграции необходимо установить дополнительный компонент.
Инструкция выглядит как обязательный этап настройки, хотя фактически уводит агента от первоначальной задачи.
Если агент воспринимает внешний текст как команду, а не как информацию для анализа, возникает нарушение границы доверия.
Здесь важно разделять два случая.
В первом злоумышленник намеренно добавляет в материал указания, рассчитанные на модель. Это косвенная prompt injection.
Во втором никакого специального внедрения нет: агент просто доверяет неверной или устаревшей инструкции и устанавливает пакет, оказавшийся под контролем третьей стороны.
Оба сценария могут привести к одной и той же проблеме — выполнению недоверенного кода. Но механизмы их возникновения различаются.
Реальный случай: агенты выполняли код из документации компаний
26 августа 2026 года исследователь Alon Hertz опубликовал результаты исследования под названием Data Became Code.
Его команда проанализировала 6 214 действующих корпоративных доменов и обнаружила тысячи файлов llms.txt и llms-full.txt.
Это машиночитаемые документы, которые некоторые сайты публикуют для облегчения доступа ИИ-систем к документации и описанию своих продуктов.
В таких файлах могут встречаться ссылки на руководства по интеграции, SDK и инструкции по установке зависимостей.
Исследователи обнаружили более 237 упоминаний незарегистрированных программных пакетов, доменов и других ресурсов.
Проблема заключалась в том, что официальная документация предлагала использовать имена, которые фактически никому не принадлежали.
Команда зарегистрировала небольшую часть свободных имён и разместила под ними безопасные тестовые пакеты. Их единственной задачей была отправка сигнала, подтверждающего выполнение.
Первое подтверждение запуска тестового кода из инфраструктуры компании Fortune 500 поступило менее чем через четыре минуты.
В дальнейшем исследователи получили дополнительные подтверждения из корпоративных сред.
В экспериментах участвовали агентные инструменты на базе Claude, Codex и Hermes. Им не требовалось напрямую указывать адрес вредоносного ресурса: агент мог самостоятельно обнаружить документацию и последовать инструкции по установке.
Отдельно исследователи обнаружили проблему в документации сервиса аутентификации Clerk.
В одном из сценариев опубликованная команда npx могла обратиться к публичному npm-реестру за пакетом, который компания не выпускала как самостоятельный продукт. Этим именем уже воспользовалась третья сторона, разместившая вредоносный пакет.
Clerk исправила проблему после уведомления. При этом публичные материалы не подтверждают, что именно этот вредоносный пакет привёл к реальным заражениям пользователей.
Особенно показательно, что для экспериментальной атаки не потребовалось изменять корпоративные сайты. Достаточно было зарегистрировать имена, которые уже присутствовали в официальной документации.
Как вредоносный модуль попадает в проект
После того как агент выбрал пакет, начинается следующий этап — установка зависимости.
Для JavaScript-проектов это обычно npm, для Python — pip. В других экосистемах используются собственные менеджеры пакетов.
На первый взгляд, установка библиотеки выглядит как рутинная операция. Однако программный пакет — это не только набор функций, которые приложение вызовет позднее.
В npm существуют lifecycle-скрипты, в том числе preinstall и postinstall. Они могут запускаться непосредственно во время установки зависимости.
Команда npx в определённых условиях также способна загрузить и запустить исполняемый файл пакета из публичного реестра.
В Python риск выполнения кода может возникать на этапах сборки пакета из исходников и при последующем импорте установленного модуля.
Это означает, что вредоносному компоненту необязательно дожидаться запуска готового приложения.
Если установка выполняется в среде разработчика или CI/CD, потенциально доступными становятся расположенные там секреты и ресурсы:
- API-ключи и токены доступа к сторонним сервисам;
- токены публикации программных пакетов;
- облачные учётные данные;
- SSH-ключи и конфигурационные файлы;
- переменные окружения;
- исходный код проекта;
- секреты, доступные процессу сборки.
При этом выполнение команды от имени ИИ-агента не делает её безопаснее. Агент использует разрешения, предоставленные его процессу и подключённым инструментам.
PromptMink: когда вредоносную зависимость выбирает AI coding agent
Ещё один показательный случай был опубликован ReversingLabs 29 апреля 2026 года.
Исследователи обнаружили, что в проекте криптовалютного торгового агента появилась вредоносная зависимость после изменений, созданных с участием AI coding agent.
В код проекта была добавлена библиотека @solana-launchpad/sdk, которая, в свою очередь, подключала вредоносный пакет @validate-sdk/v2.
Последний выдавал себя за обычный инструмент проверки данных, но содержал функции сбора конфиденциальной информации.
По оценке ReversingLabs, злоумышленники специально делали документацию и описания пакетов убедительными для языковых моделей. Цель заключалась в том, чтобы агент воспринимал библиотеку как подходящее решение для своей задачи.
Такой подход исследователи описали как злоупотребление LLM Optimization (LLMO) и knowledge injection.
Это важное отличие от обычной подмены имени пакета: атакующий пытается повлиять не только на то, откуда будет загружен код, но и на то, почему ИИ вообще выберет именно этот компонент.
Само исследование не доказывает, что выбор зависимости был вызван непосредственно отравленной поисковой выдачей. Но оно подтверждает более широкий механизм: вредоносная библиотека может оказаться в настоящем проекте вследствие решения ИИ-агента.
Подробнее: ReversingLabs — Claude adds malware to crypto agent.
Slopsquatting: даже поисковая выдача не обязательна
Иногда атакующему вообще не требуется подменять результаты поиска.
Языковые модели могут рекомендовать библиотеки, которых в действительности не существует. Они формируют правдоподобные названия на основе знакомых шаблонов и комбинаций существующих проектов.
Эту особенность используют в атаках, получивших название slopsquatting.
Злоумышленник выявляет названия несуществующих пакетов, которые регулярно появляются в ответах ИИ, и регистрирует их в публичном реестре.
Если агент позднее предложит одно из этих названий и попытается установить соответствующую зависимость, пакет уже будет существовать — но контролировать его будет атакующий.
От классического typosquatting это отличается принципиально.
При typosquatting жертва ошибается при вводе имени популярной библиотеки.
При slopsquatting имя может быть написано совершенно правильно. Просто его изначально придумала модель.
В исследовании, опубликованном в мае 2026 года, изучались современные модели генерации кода. Авторы обнаружили, что даже более новые модели продолжают предлагать несуществующие зависимости, причём некоторые выдуманные названия повторяются у разных моделей.
Таким образом, публичный реестр пакетов может стать местом, где ошибка модели превращается в механизм доставки вредоносного кода.
Почему традиционные средства защиты могут не заметить атаку
Главная сложность подобных сценариев заключается в том, что отдельные действия могут выглядеть легитимно.
ИИ-агент использует разрешённый поисковый инструмент, обращается к доступной по HTTPS документации и запускает стандартный менеджер пакетов.
Дальше npm или pip обращается к привычному публичному репозиторию.
Ни один из этих шагов сам по себе не обязательно выглядит подозрительно.
Проблема возникает в момент, когда непроверенный внешний материал начинает определять действия системы, обладающей правом выполнения кода.
Наличие HTTPS подтверждает защищённость соединения с сайтом, но не безопасность всех опубликованных на нём инструкций.
А факт публикации пакета в npm или PyPI не гарантирует, что он принадлежит ожидаемому разработчику либо не содержит вредоносного функционала.
Даже подпись или подтверждённое происхождение сборки не всегда решают эту задачу: они помогают установить источник артефакта, но не доказывают его безопасность.
Как защитить ИИ-агентов и инфраструктуру разработки
Полностью отказаться от автоматизации необязательно. Гораздо эффективнее ограничить последствия ошибочных решений агента и установить правила работы с зависимостями.
1. Запретить бесконтрольную установку новых зависимостей
ИИ-агент может выбирать и предлагать библиотеки, но добавление нового пакета в проект должно проходить отдельную проверку или утверждение.
Особенно важно контролировать пакеты, которых ранее не было в проекте и которые не входят в список разрешённых компонентов.
2. Проверять происхождение пакетов
Перед установкой важно установить, кто является сопровождающим проекта, насколько давно опубликован пакет, соответствует ли он официальному репозиторию и действительно ли указан в документации разработчика.
При этом возраст пакета и количество загрузок — лишь дополнительные сигналы, а не доказательства безопасности.
3. Использовать контролируемые реестры и анализ зависимостей
Внутренние репозитории, allowlist-политики, Software Composition Analysis (SCA) и анализ вредоносных компонентов позволяют снизить вероятность попадания неизвестных пакетов в проект.
Проверка должна распространяться не только на прямые, но и на транзитивные зависимости.
4. Изолировать среду выполнения агента
Установка стороннего кода должна по возможности происходить в одноразовой среде без доступа к production-секретам, рабочим SSH-ключам и привилегированным облачным учётным данным.
Контейнеризация полезна, но сама по себе не гарантирует изоляции: необходимо ограничивать монтирования, полномочия и сетевой доступ.
5. Разделять внешнюю информацию и инструкции
Результаты поиска, содержимое сайтов и ответы MCP-инструментов должны рассматриваться как недоверенные данные.
Найденная инструкция по установке не должна автоматически превращаться в разрешение выполнить команду.
Особенно опасны сценарии, в которых ИИ-агент может самостоятельно искать информацию, устанавливать программные компоненты и выполнять их без дополнительного контроля.
6. Контролировать действия в терминале
Для операций установки, запуска скриптов и изменения инфраструктуры стоит предусмотреть политики разрешений, журналирование и подтверждение рискованных действий.
Особого внимания заслуживают команды, которые загружают исполняемый код из интернета или запускают ранее неизвестные пакеты.
7. Проверять собственную документацию для ИИ
Если компания публикует llms.txt, AGENTS.md, инструкции по установке SDK или другие материалы для агентов, их следует включить в область контроля целостности.
Необходимо убедиться, что указанные имена пакетов, домены и команды действительно принадлежат компании или доверенным поставщикам.
Что делать, если агент уже установил подозрительную библиотеку
Простое удаление зависимости не гарантирует устранения последствий.
Если установочный скрипт уже выполнился, он мог получить доступ к секретам, создать дополнительные файлы или запустить сторонние процессы.
В таком случае рекомендуется выполнить следующие действия:
- Изолировать затронутую среду от других корпоративных систем.
- Сохранить журналы выполнения команд и историю действий ИИ-агента.
- Зафиксировать версии и контрольные суммы установленных пакетов.
- Проверить запущенные процессы, созданные файлы и сетевые соединения.
- Определить, к каким секретам и ресурсам имел доступ процесс установки.
- При наличии риска компрометации отозвать и перевыпустить соответствующие токены и ключи.
- Восстановить затронутую среду из доверенного состояния и устранить причину установки подозрительного компонента.
Учётные данные, доступные процессу во время установки, следует рассматривать как потенциально скомпрометированные.
Для CI/CD и рабочих окружений с высоким уровнем доверия безопаснее восстановить среду из проверенного состояния, чем полагаться исключительно на удаление подозрительного пакета.
Вывод: поисковая выдача больше не просто источник информации
Раньше злоумышленник, отравлявший поисковую выдачу, рассчитывал, что человек перейдёт по ссылке, скачает файл и запустит его.
Теперь в некоторых сценариях эту последовательность способен выполнить ИИ-агент.
Атакующий воздействует на информацию, которую агент использует для решения задачи, а затем полагается на предоставленные агенту полномочия.
При этом компрометация возможна даже без классического prompt injection: достаточно ошибочной инструкции, незарегистрированного имени пакета или убедительно оформленной вредоносной библиотеки.
Ключевая проблема не в том, что ИИ умеет искать информацию. Проблема возникает тогда, когда найденный текст становится основанием для выполнения кода без независимой проверки.
По мере распространения автономных помощников безопасность цепочки поставок должна охватывать не только исходный код и установленные зависимости, но и весь путь принятия решения: от поискового запроса до запуска команды.
Потому что следующая вредоносная зависимость может оказаться в проекте не после ошибки разработчика, а после вполне успешного выполнения задачи его ИИ-ассистентом.