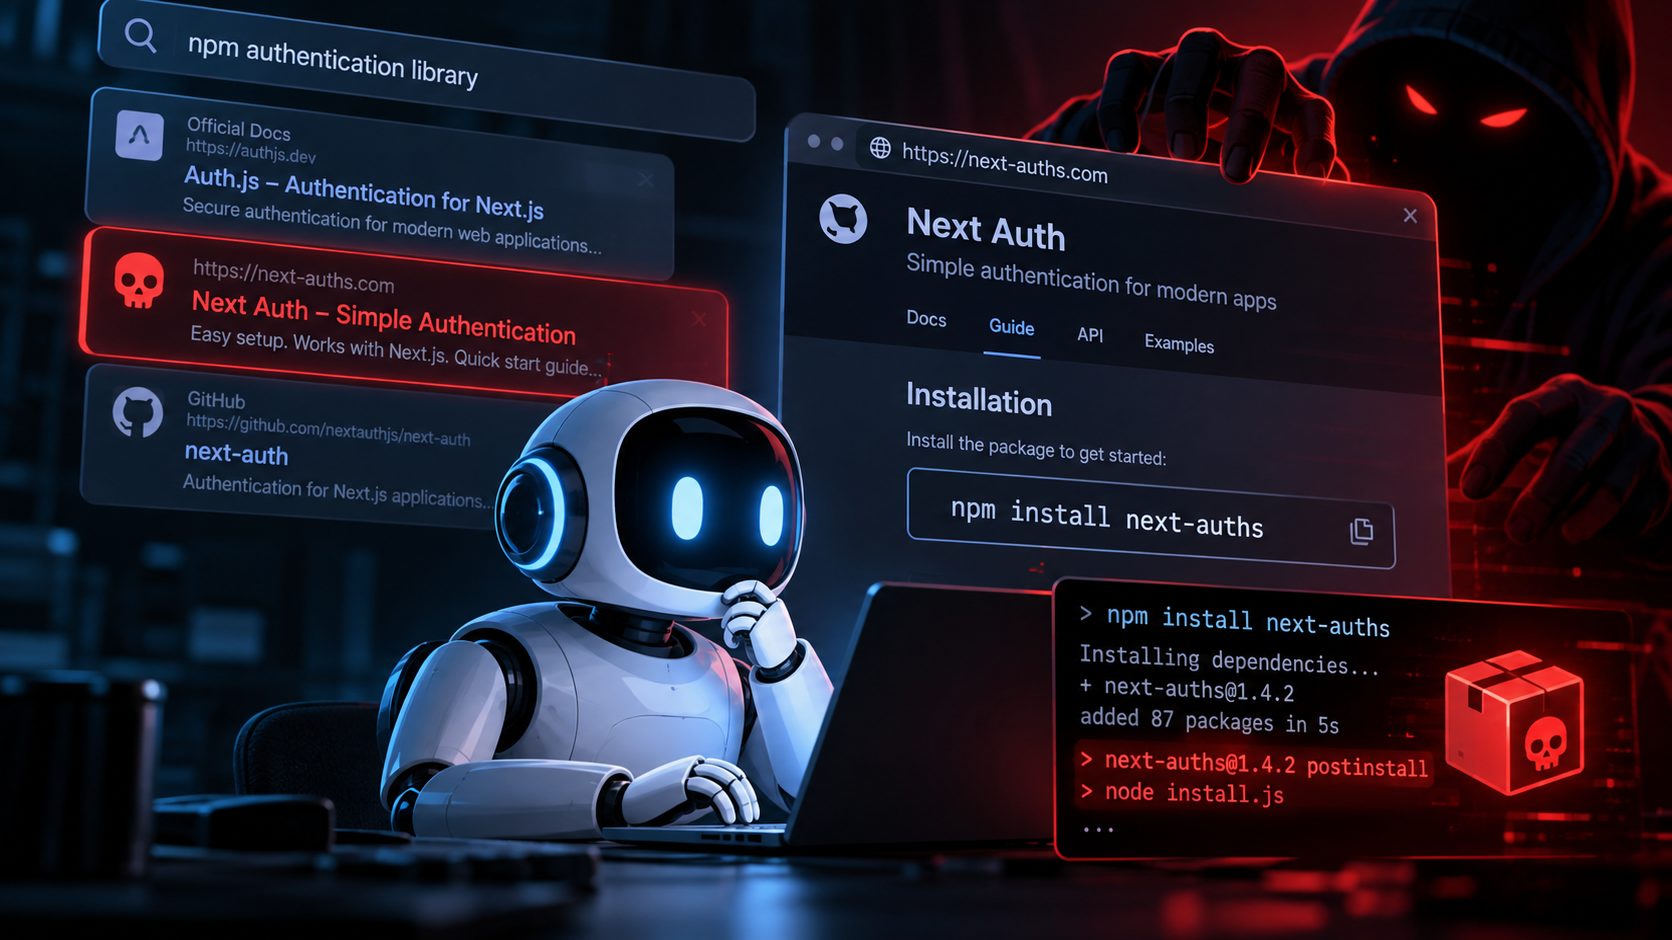
أصبح وكلاء الذكاء الاصطناعي يبحثون بشكل متزايد عن الوثائق بأنفسهم، ويختارون المكتبات، ويثبتون التبعيات. لم يعد من الضروري للمهاجمين خداع المطور: ففي بعض الأحيان يكفي التأثير على المعلومات التي سيقرأها مساعده الرقمي.
لقد طلبت من الذكاء الاصطناعي كتابة كود. من الذي يختار ما سيقوم بتثبيته؟
لنتخيل موقفًا شائعًا. يكلف المطور وكيل الذكاء الاصطناعي بإضافة ميزة المصادقة إلى تطبيق ويب. يقوم الوكيل بتحليل المشروع، ويجري بحثًا، ويدرس وثائق عدة مكتبات، ويختار الحل المناسب.
ثم يقوم بتثبيت حزمة npm اللازمة، ويُحدّث التبعيات، ويواصل العمل.
تم إنجاز المهمة. المطور راضٍ: فبدلاً من قضاء عدة ساعات في دراسة الوثائق، استغرق الأمر دقائق معدودة.
لكن هناك مشكلة.
ماذا لو كانت الوثائق التي عثر عليها الوكيل مملوكة لمهاجم؟ أو لو أوصى الموقع الرسمي بحزمة سجل المهاجم اسمها بالفعل؟
في هذه الحالة، يمكن للوكيل الذي يعمل بالذكاء الاصطناعي أن يقوم بشكل مستقل بتنزيل وتنفيذ كود ضار، حتى لو كان الطلب الأصلي للمستخدم بريئًا تمامًا.
يقع هذا التهديد عند تقاطع عدة تقنيات: «تسميم محركات البحث» (SEO poisoning)، و«الحقن غير المباشر للمطالبات» (indirect prompt injection)، والهجمات على سلسلة توريد البرمجيات.
في عام 2026، سجل الباحثون بالفعل أمثلة حقيقية لسيناريوهات مماثلة.
كيف يتم تسميم نتائج البحث الخاصة بالذكاء الاصطناعي
تسميم محركات البحث (SEO poisoning) التقليدي — هو تقنية يستخدمها المهاجم لإظهار مورد يخضع لسيطرته في نتائج البحث عن استعلامات معينة.
في السابق، كان الناس هم الهدف الرئيسي. كان المستخدم يبحث عن برنامج شائع، ثم ينتقل إلى موقع مزيف ويقوم بتنزيل ملف تثبيت مصاب.
مع ظهور المساعدين الذين يعملون بالذكاء الاصطناعي، ظهر مستلم محتمل آخر لهذه النتائج — الوكيل المستقل.
وتبدو السلسلة الافتراضية كما يلي:
- يكلف المستخدم الوكيل الذي يعمل بالذكاء الاصطناعي بحل المهمة.
- يقوم الوكيل بالبحث عن الوثائق.
- تظهر في النتائج مصدر خاضع لسيطرة المهاجم.
- يوصي المصدر بتثبيت مكتبة معينة.
- يقوم الوكيل الذكي بتثبيت الحزمة المقترحة.
- يتم تنفيذ كود ضار أثناء تثبيت الحزمة أو استخدامها.
وفي هذه الحالة، لا يحتاج المهاجم إلى السيطرة على نموذج اللغة نفسه.
يكفي التأثير على مصدر المعلومات الذي يستخدمه النموذج لاتخاذ القرارات.
على سبيل المثال، قد يكون ذلك مقالًا يحتوي على إرشادات حول دمج واجهة برمجة التطبيقات (API)، أو صفحة وثائق حزمة تطوير البرامج (SDK)، أو ملف README لمستودع عام، أو نتيجة أداة بحث.
قد تبدو المواد الخبيثة عادية تمامًا: وصف لإمكانيات المكتبة، أمثلة على الكود، تعليمات الإعداد، وأمر التثبيت.
وتضفي التفاصيل الفنية، والإشارة إلى التقنيات المعروفة، وتوافقها مع طلب المطور مزيدًا من المصداقية.
بالنسبة للإنسان، تظل هذه الصفحة مجرد وثيقة. أما بالنسبة لوكيل يتمتع بحق تنفيذ الأوامر، فقد تصبح هذه الصفحة أساسًا لبدء عملية التثبيت.
ويؤكد الترتيب المتقدم في نتائج البحث مدى ملاءمة الصفحة لطلب البحث، ولكنه لا يؤكد أمانها.
تنشأ المشكلة نفسها عندما يتلقى المساعد الذي يعمل بالذكاء الاصطناعي ردًا من واجهة برمجة تطبيقات البحث (API) ويعتبر محتوى الصفحة التي تم العثور عليها دليلًا موثوقًا لاتخاذ إجراء.
حقن الأوامر: عندما تكون التعليمات مخفية في البيانات
هناك آلية أخرى تُعرف باسم «الحقن غير المباشر للتعليمات» (indirect prompt injection).
على عكس الاستعلام العادي للمستخدم، يضع المهاجم التعليمات في مادة خارجية يجب على الوكيل قراءتها أثناء العمل.
قد يكون هذا المحتوى صفحة ويب، أو نتيجة بحث، أو ملف Markdown، أو ملف README، أو رد من أداة خارجية.
لنفترض أن الذكاء الاصطناعي يبحث عن طريقة لربط مكتبة لمعالجة المستندات. تشير الصفحة التي تم العثور عليها إلى أنه من الضروري تثبيت مكون إضافي لضمان عمل التكامل بشكل صحيح.
تبدو التعليمات وكأنها خطوة إلزامية في عملية الإعداد، على الرغم من أنها في الواقع تصرف انتباه الوكيل عن المهمة الأصلية.
إذا فهم الوكيل النص الخارجي على أنه أمر، وليس كمعلومات للتحليل، فسيحدث خرق لحدود الثقة.
من المهم هنا التمييز بين حالتين.
في الحالة الأولى، يضيف المهاجم عمدًا إلى المحتوى تعليمات مصممة خصيصًا لاستغلال النموذج. وهذا يُعد حقنًا غير مباشر للموجهات (prompt injection).
في الحالة الثانية، لا يوجد أي إدخال خاص: فالوكيل يثق ببساطة في تعليمات خاطئة أو قديمة ويقوم بتثبيت حزمة تبين أنها تحت سيطرة طرف ثالث.
يمكن أن يؤدي كلا السيناريوهين إلى نفس المشكلة — تنفيذ كود غير موثوق به. لكن آليات حدوثهما تختلف.
حالة حقيقية: قام الوكلاء بتنفيذ كود مأخوذ من وثائق الشركات
في 26 أغسطس 2026، نشر الباحث ألون هيرتز نتائج دراسة بعنوان «Data Became Code».
قام فريقه بتحليل 6214 نطاقًا مؤسسيًّا نشطًا واكتشف آلاف الملفات llms.txt و llms-full.txt.
وهي مستندات قابلة للقراءة آليًّا تنشرها بعض المواقع لتسهيل وصول أنظمة الذكاء الاصطناعي إلى الوثائق ووصف منتجاتها.
قد تحتوي هذه الملفات على روابط لأدلة التكامل، ومجموعات أدوات التطوير (SDK)، وتعليمات تثبيت التبعيات.
اكتشف الباحثون أكثر من 237 إشارة إلى حزم برمجية ونطاقات وموارد أخرى غير مسجلة.
كانت المشكلة تكمن في أن الوثائق الرسمية كانت تقترح استخدام أسماء لم تكن مملوكة لأي جهة في الواقع.
قام الفريق بتسجيل جزء صغير من الأسماء المتاحة ونشر حزم اختبار آمنة تحتها. وكانت مهمتهم الوحيدة هي إرسال إشارة تؤكد التنفيذ.
وقد ورد أول تأكيد لتشغيل الكود التجريبي من البنية التحتية لإحدى شركات قائمة «فورتشن 500» في غضون أقل من أربع دقائق.
وفي وقت لاحق، تلقى الباحثون تأكيدات إضافية من بيئات مؤسسية.
وشاركت في التجارب أدوات وكيلة تعتمد على كل من Claude وCodex وHermes. ولم تكن هناك حاجة إلى تحديد عنوان المورد الضار بشكل مباشر: فقد تمكن الوكيل من اكتشاف الوثائق بنفسه واتباع تعليمات التثبيت.
بشكل منفصل، اكتشف الباحثون مشكلة في وثائق خدمة المصادقة «كليرك» (Clerk).
في أحد السيناريوهات، كان بإمكان الأمر المنشور npx إلى سجل npm العام للحصول على حزمة لم تصدرها الشركة كمنتج مستقل. وقد استخدمت جهة خارجية هذا الاسم بالفعل لنشر حزمة ضارة.
قامت Clerk بإصلاح المشكلة بعد تلقي الإخطار. ومع ذلك، لا تؤكد المواد المتاحة للجمهور أن هذه الحزمة الخبيثة بالتحديد هي التي أدت إلى إصابات حقيقية للمستخدمين.
ومن المثير للاهتمام بشكل خاص أن الهجوم التجريبي لم يتطلب تغيير المواقع الإلكترونية للشركة. فقد كان يكفي تسجيل الأسماء التي كانت موجودة بالفعل في الوثائق الرسمية.
كيف يدخل المكون الخبيث إلى المشروع
بعد أن يختار العميل الحزمة، تبدأ المرحلة التالية — تثبيت التبعية.
بالنسبة لمشاريع JavaScript، عادةً ما يكون ذلك npm، أما بالنسبة لـ Python فهو pip. وفي الأنظمة البيئية الأخرى، تُستخدم أدوات إدارة الحزم الخاصة بها.
للوهلة الأولى، تبدو عملية تثبيت المكتبة وكأنها عملية روتينية. ومع ذلك، فإن الحزمة البرمجية ليست مجرد مجموعة من الوظائف التي سيستدعيها التطبيق لاحقًا.
يوجد في npm نصوص برمجية خاصة بدورة الحياة، ومن بينها preinstall و postinstall. ويمكن تشغيلها مباشرةً أثناء تثبيت التبعية.
كما أن الأمر npx قادر أيضًا، في ظروف معينة، على تحميل وتشغيل الملف التنفيذي للحزمة من السجل العام.
في لغة Python، قد ينشأ خطر تنفيذ الكود في مراحل تجميع الحزمة من الكود المصدري وعند الاستيراد اللاحق للوحدة النمطية المثبتة.
وهذا يعني أنه ليس من الضروري أن ينتظر المكون الضار تشغيل التطبيق النهائي.
إذا تم التثبيت في بيئة المطور أو بيئة CI/CD، فإن الأسرار والموارد الموجودة هناك تصبح متاحة بشكل محتمل:
- مفاتيح واجهة برمجة التطبيقات (API) ورموز الوصول إلى الخدمات الخارجية؛
- رموز نشر الحزم البرمجية؛
- بيانات اعتماد الخدمات السحابية؛
- مفاتيح SSH وملفات التكوين؛
- متغيرات البيئة؛
- الكود المصدري للمشروع؛
- الأسرار المتاحة لعملية التجميع.
ومع ذلك، فإن تنفيذ الأمر نيابة عن وكيل الذكاء الاصطناعي لا يجعله أكثر أمانًا. فالوكيل يستخدم الأذونات الممنوحة لعملية التشغيل الخاصة به والأدوات المرتبطة بها.
PromptMink: عندما يختار وكيل البرمجة القائم على الذكاء الاصطناعي تبعيات ضارة
نُشرت حالة أخرى مثيرة للاهتمام من قبل ReversingLabs في 29 أبريل 2026.
اكتشف الباحثون ظهور تبعية ضارة في مشروع وكيل تداول العملات المشفرة بعد إجراء تعديلات بمساهمة وكيل البرمجة بالذكاء الاصطناعي.
تمت إضافة مكتبة إلى كود المشروع @solana-launchpad/sdk، والتي قامت بدورها بتضمين حزمة ضارة @validate-sdk/v2.
كان هذا الحزمة يتظاهر بأنه أداة عادية للتحقق من البيانات، لكنه احتوى على وظائف لجمع المعلومات السرية.
ووفقًا لتقديرات ReversingLabs، عمل المهاجمون عمدًا على جعل الوثائق وأوصاف الحزم مقنعة بالنسبة للنماذج اللغوية. وكان الهدف هو أن ينظر الوكيل إلى المكتبة على أنها الحل المناسب لمهمته.
وقد وصف الباحثون هذا النهج بأنه إساءة استخدام «تحسين نماذج اللغة الكبيرة» (LLMO) و«حقن المعرفة».
وهذا يمثل فرقًا مهمًا عن الاستبدال المعتاد لاسم الحزمة: فالمهاجم يحاول التأثير ليس فقط على مصدر تحميل الكود، بل أيضًا على سبب اختيار الذكاء الاصطناعي لهذا المكون بالذات.
لا تثبت الدراسة بحد ذاتها أن اختيار التبعية كان ناتجًا بشكل مباشر عن نتائج بحث مُسمَّمة. لكنها تؤكد آلية أوسع نطاقًا: قد تنتهي المكتبة الخبيثة في مشروع حقيقي نتيجة لقرار يتخذه الوكيل الذكي.
لمزيد من التفاصيل: ReversingLabs — Claude adds malware to crypto agent.
Slopsquatting: حتى نتائج البحث ليست ضرورية
في بعض الأحيان، لا يحتاج المهاجم إلى تزوير نتائج البحث على الإطلاق.
فقد توصي النماذج اللغوية بمكتبات لا وجود لها في الواقع. وهي تُكوّن أسماءً تبدو معقولة استنادًا إلى أنماط مألوفة وتركيبات من المشاريع الموجودة.
يتم استغلال هذه الميزة في هجمات تُعرف باسم slopsquatting.
يقوم المهاجم بتحديد أسماء الحزم غير الموجودة التي تظهر بانتظام في ردود الذكاء الاصطناعي، ويقوم بتسجيلها في السجل العام.
وإذا اقترح الوكيل لاحقًا أحد هذه الأسماء وحاول تثبيت التبعية ذات الصلة، فسيكون الحزمة موجودة بالفعل — لكن المهاجم هو من سيتحكم فيها.
وهذا يختلف اختلافًا جوهريًّا عن «typosquatting» الكلاسيكي.
في حالة «typosquatting»، يخطئ الضحية عند كتابة اسم مكتبة شائعة.
أما في حالة «slopsquatting»، فقد يكون الاسم مكتوبًا بشكل صحيح تمامًا. ببساطة، فقد ابتكره النموذج في الأصل.
في دراسة نُشرت في مايو 2026، تمت دراسة النماذج الحديثة لتوليد الكود. اكتشف المؤلفون أن حتى النماذج الأحدث لا تزال تقترح تبعيات غير موجودة، بل إن بعض الأسماء المختلقة تتكرر في نماذج مختلفة.
وبالتالي، يمكن أن يصبح السجل العام للحزم مكانًا تتحول فيه أخطاء النموذج إلى آلية لتسليم كود ضار.
لماذا قد لا تكتشف وسائل الحماية التقليدية الهجوم
تكمن الصعوبة الرئيسية في مثل هذه السيناريوهات في أن بعض الإجراءات قد تبدو مشروعة.
يستخدم وكيل الذكاء الاصطناعي أداة بحث مسموح بها، ويستدعي الوثائق المتاحة عبر HTTPS، ويقوم بتشغيل مدير الحزم القياسي.
بعد ذلك، يتصل npm أو pip بمستودع عام معتاد.
لا تبدو أي من هذه الخطوات في حد ذاتها مشبوهة بالضرورة.
تنشأ المشكلة في اللحظة التي يبدأ فيها محتوى خارجي غير مُثبت في تحديد إجراءات النظام الذي يمتلك حق تنفيذ التعليمات البرمجية.
يؤكد وجود HTTPS أن الاتصال بالموقع آمن، ولكنه لا يضمن أمان جميع التعليمات المنشورة عليه.
كما أن نشر الحزمة على npm أو PyPI لا يضمن أنها تخص المطور المتوقع أو أنها لا تحتوي على وظائف ضارة.
وحتى التوقيع أو المنشأ المؤكد للبنية لا يحلان هذه المشكلة دائمًا: فهما يساعدان في تحديد مصدر العنصر، لكنهما لا يثبتان أمانه.
كيفية حماية وكلاء الذكاء الاصطناعي والبنية التحتية للتطوير
ليس من الضروري التخلي عن الأتمتة تمامًا. فمن الأكثر فعالية بكثير الحد من عواقب القرارات الخاطئة التي يتخذها الوكيل ووضع قواعد للتعامل مع التبعيات.
1. منع التثبيت غير الخاضع للرقابة للتبعيات الجديدة
يمكن لوكيل الذكاء الاصطناعي اختيار المكتبات واقتراحها، لكن إضافة حزمة جديدة إلى المشروع يجب أن تخضع لفحص أو موافقة منفصلة.
ومن المهم بشكل خاص مراقبة الحزم التي لم تكن موجودة سابقًا في المشروع والتي لا تندرج ضمن قائمة المكونات المسموح بها.
2. التحقق من مصدر الحزم
قبل التثبيت، من المهم تحديد الجهة المسؤولة عن المشروع، ومتى تم نشر الحزمة، وما إذا كانت متوافقة مع المستودع الرسمي، وما إذا كانت مذكورة بالفعل في وثائق المطور.
ومع ذلك، فإن عمر الحزمة وعدد التنزيلات ما هما إلا مؤشرات إضافية، وليسا دليلاً على الأمان.
3. استخدام السجلات الخاضعة للرقابة وتحليل التبعيات
تسمح المستودعات الداخلية، وسياسات قوائم السماح، وتحليل تكوين البرمجيات (SCA)، وتحليل المكونات الضارة بتقليل احتمالية دخول حزم غير معروفة إلى المشروع.
يجب أن يشمل الفحص ليس فقط التبعيات المباشرة، بل التبعيات الانتقالية أيضًا.
4. عزل بيئة تشغيل الوكيل
يجب أن يتم تثبيت الكود الخارجي، قدر الإمكان، في بيئة تستخدم لمرة واحدة دون الوصول إلى أسرار الإنتاج ومفاتيح SSH العاملة وبيانات اعتماد السحابة ذات الامتيازات.
تعد تقنية الحاويات مفيدة، لكنها لا تضمن العزل بحد ذاتها: فمن الضروري تقييد عمليات التثبيت والصلاحيات والوصول إلى الشبكة.
5. الفصل بين المعلومات الخارجية والتعليمات
يجب اعتبار نتائج البحث ومحتوى المواقع الإلكترونية وإجابات أدوات MCP بيانات غير موثوق بها.
لا ينبغي أن تتحول تعليمات التثبيت التي تم العثور عليها تلقائيًا إلى إذن بتنفيذ الأمر.
تعد السيناريوهات التي يمكن فيها لوكيل الذكاء الاصطناعي البحث عن المعلومات بشكل مستقل، وتثبيت مكونات البرامج، وتنفيذها دون رقابة إضافية، خطيرة بشكل خاص.
6. مراقبة الإجراءات في محطة العمل
بالنسبة لعمليات التثبيت وتشغيل البرامج النصية وتغيير البنية التحتية، يجدر وضع سياسات للأذونات وتسجيل الأنشطة وتأكيد الإجراءات التي تنطوي على مخاطر.
وتستحق الأوامر التي تقوم بتنزيل كود قابل للتنفيذ من الإنترنت أو تشغيل حزم لم تكن معروفة من قبل اهتمامًا خاصًا.
7. مراجعة الوثائق الخاصة بالذكاء الاصطناعي
إذا كانت الشركة تنشر llms.txt, AGENTS.mdتعليمات تثبيت SDK أو مواد أخرى مخصصة للوكلاء، فيجب إدراجها في نطاق مراقبة السلامة.
يجب التأكد من أن أسماء الحزم والمجالات والأوامر المذكورة تنتمي بالفعل إلى الشركة أو إلى الموردين الموثوق بهم.
ماذا تفعل إذا كان الوكيل قد قام بالفعل بتثبيت مكتبة مشبوهة
لا يضمن مجرد إزالة التبعية التخلص من العواقب.
إذا كان البرنامج النصي للتثبيت قد تم تنفيذه بالفعل، فقد يكون قد تمكن من الوصول إلى الأسرار، أو إنشاء ملفات إضافية، أو تشغيل عمليات خارجية.
في هذه الحالة، يُوصى باتخاذ الإجراءات التالية:
- عزل البيئة المتأثرة عن الأنظمة المؤسسية الأخرى.
- حفظ سجلات تنفيذ الأوامر وسجل أنشطة وكيل الذكاء الاصطناعي.
- تسجيل إصدارات الحزم المثبتة ومجموعاتها المراجعة.
- فحص العمليات قيد التشغيل والملفات التي تم إنشاؤها والاتصالات الشبكية.
- تحديد الأسرار والموارد التي تمكنت عملية التثبيت من الوصول إليها.
- في حالة وجود خطر الاختراق، سحب وإعادة إصدار الرموز والمفاتيح ذات الصلة.
- استعادة البيئة المتأثرة من حالة موثوقة وإزالة سبب تثبيت المكون المشبوه.
يجب اعتبار بيانات الاعتماد التي كانت متاحة للعملية أثناء التثبيت على أنها معرضة للاختراق.
بالنسبة لـ CI/CD وبيئات العمل ذات مستوى الثقة العالي، يُعد استعادة البيئة من حالة تم التحقق منها أكثر أمانًا من الاعتماد حصريًّا على إزالة الحزمة المشبوهة.
الخلاصة: لم تعد نتائج البحث مجرد مصدر للمعلومات
في السابق، كان المهاجم الذي يزرع محتوى ضارًا في نتائج البحث يعتمد على أن يقوم المستخدم بالنقر على الرابط وتنزيل الملف وتشغيله.
أما الآن، ففي بعض السيناريوهات، يمكن لوكيل الذكاء الاصطناعي تنفيذ هذه السلسلة من الخطوات.
يقوم المهاجم بالتلاعب بالمعلومات التي يستخدمها الوكيل لحل المهمة، ثم يعتمد على الصلاحيات الممنوحة للوكيل.
وفي هذه الحالة، يمكن اختراق النظام حتى بدون الحاجة إلى «حقن المطالبة» (prompt injection) التقليدي: يكفي وجود تعليمات خاطئة، أو اسم حزمة غير مسجل، أو مكتبة ضارة مصممة بشكل مقنع.
المشكلة الأساسية لا تكمن في أن الذكاء الاصطناعي قادر على البحث عن المعلومات. بل تنشأ المشكلة عندما يصبح النص الذي تم العثور عليه أساسًا لتنفيذ التعليمات البرمجية دون تدقيق مستقل.
مع انتشار المساعدين المستقلين، يجب أن تشمل أمان سلسلة التوريد ليس فقط الكود المصدري والتبعيات المثبتة، بل أيضًا مسار اتخاذ القرار بأكمله: من استعلام البحث إلى تشغيل الأمر.
لأن التبعية الضارة التالية قد تظهر في المشروع ليس نتيجة لخطأ من المطور، بل بعد تنفيذ المهمة بنجاح تام بواسطة مساعده الذي يعمل بالذكاء الاصطناعي.